不去猜 AI 喜欢什么,先看豆包这一次搜了什么、读了谁,再回头改自己。这是一个刚起步的小应用做豆包 GEO 优化的实测记录。
最近我发现,开始有越来越多的用户订阅我的 App。我去了解了一下,发现他们大部分都来自豆包、元宝这些 AI 工具;而且这个渠道过来的用户目的明确,下载转化率高,付费转化也好。我了解过的几个核心付费用户,都是这么找到我的。
我做的这个 App 叫记忆小怪兽,帮小学生背课文、背古诗,去年 11 月在这个号上正式启动。它还很小,所以我想把这个渠道认真做一做。这件事现在有个很火的名字,叫 GEO(生成式引擎优化),说白了,就是想办法让 AI 在回答里提到你。
网上讲 GEO 优化的文章不少,大多在讲“AI 喜欢什么样的内容”。我用的方法很土,土到起点只是豆包回答顶上的一行小字:点开它,就能看到豆包这一次搜了什么、读了谁,再倒回来查自己缺什么。
下面是整个过程。数字都来自我自己的记录,样本很小,每个结论能信到哪一步,我会标清楚。
先看一张截图
这是豆包网页版的一次回答,问的是“小学生背诵 app 推荐”。
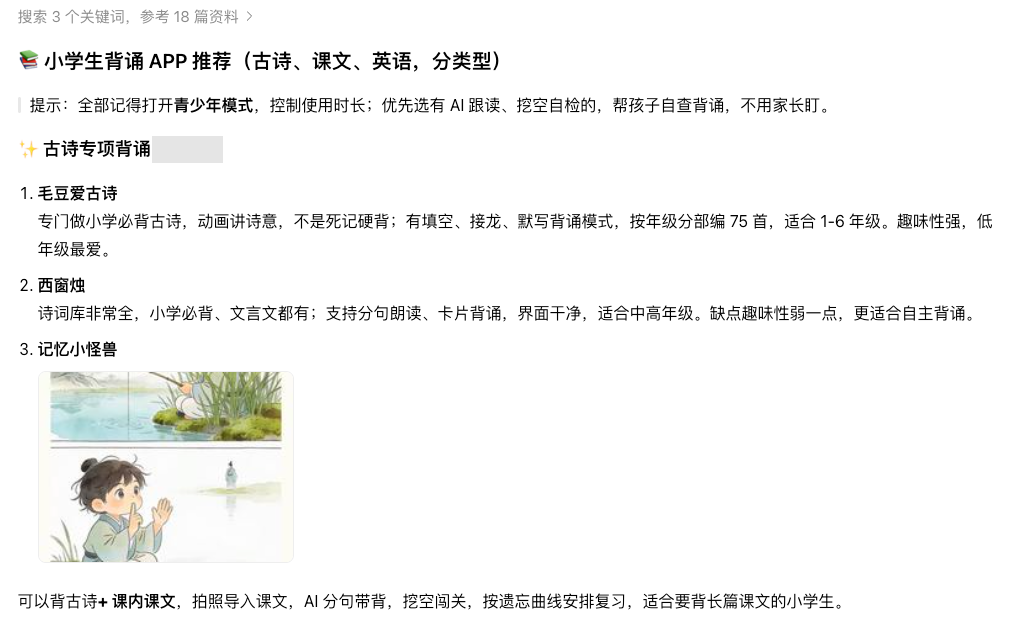 图① 我排在第 3 个。但真正该看的,是最上面那行小字
回答按类型分了组。记忆小怪兽在第一组“古诗专项背诵”里排第 3,介绍是“可以背古诗+课内课文,拍照导入课文,AI 分句带背,挖空闯关,按遗忘曲线安排复习”。
我最在意的,就是回答最上面那行灰色小字:搜索 3 个关键词,参考 18 篇资料。
这说明豆包在回答之前,先去网上搜了一轮。我很可能是被它当场搜到、读到的,而不是它本来就“知道”我。
AI 回答问题,大致有两种状态:一种是直接凭模型记住的东西答,另一种是先联网搜一轮,再根据搜到的资料答。刚起步的小应用,模型大概率没记住你。所以对你来说,豆包这一次搜没搜,基本决定了你有没有机会出现。
同一天,只改一下问法
为了确认这一点,我让 AI 编程助手 Claude Code 在豆包网页版上开了两个新的匿名对话(不登录,没有历史记录),前后只隔了一分多钟,区别只在问法。
第一个问得很泛:“帮我推荐下市面上针对小学生背诵比较好的应用”。回答上面没有那行“搜索……参考……”的小字,也就是没去搜。它直接列了 7 个应用,都是模型自己记得的名字,答得比较笼统,里面至少有 3 个是背单词的。记忆小怪兽不在里面。
第二个问得具体:“2026 年有哪些适合小学生背课文的 App?最好是能拍照导入课文、AI 带背的”。这次顶上出现了“搜索 5 个关键词,参考 25 篇资料”,记忆小怪兽排在第 1 个。
后来我自己又去试了一次。只问“小学生app推荐”,回答里没有我;把“背诵”两个字加回去,问“小学生背诵app推荐”,回答里第 2 个就是我们。差两个字,结果就不一样。
这一次我顺手也点开了面板:顶上写着“搜索 3 个关键词,参考 15 篇资料”,展开后那三个词是“小学生背诵app推荐 好用”“小学生背诵app推荐”“适合小学生背诵课文古诗词的软件”。问题我只打了一句,它自己拆成了三个。
但两三次对比说明不了什么。“问得越具体,越容易触发搜索”,目前只是我这几次看到的倾向,算不上规律。能确定的只有一件事:那次没去搜,回答里就没有我。
点开“参考 25 篇资料”
那行小字右边有个小箭头,点开就是一个资料面板:上面一行是豆包改写后的搜索词,下面是它参考的资料,一条一条编好号。
面板里能看到的是网页标题,不是网址。想知道每一条到底来自哪个网站,有两个办法:一是直接看标题,App Store 的页面标题末尾都带着一句“App - App Store”;二是去页面源码里把每条的链接取出来。我让 Claude Code 用浏览器打开这个会话、展开面板,把标题和链接一起存了一份——十几条一条条抄太慢,也容易抄错。
一句问题,被豆包改写成了 5 个词:
- 2026 小学生背课文app 拍照导入 AI带背
- 适合小学生背诵app推荐 拍照导入课文
- 可以拍照识别课文 AI辅助背诵的app 小学生
- 拍照导入课文背诵软件使用教程
- 小学生AI带背课文APP推荐
第 4 个最值得看。提问里根本没有“教程”两个字,是豆包自己加的。它想找一篇讲“拍照导入课文怎么用”的教程,而我们的官网上没有这样一页。
反推就从这里开始:要优化的,不是你想象中用户会问的那句话,而是豆包改写之后真正拿去搜的这几个词。
它读了谁
同一个面板里,还列着它参考的资料。它说参考了 25 篇,展开后能看到 13 条。我按网站数了一遍:
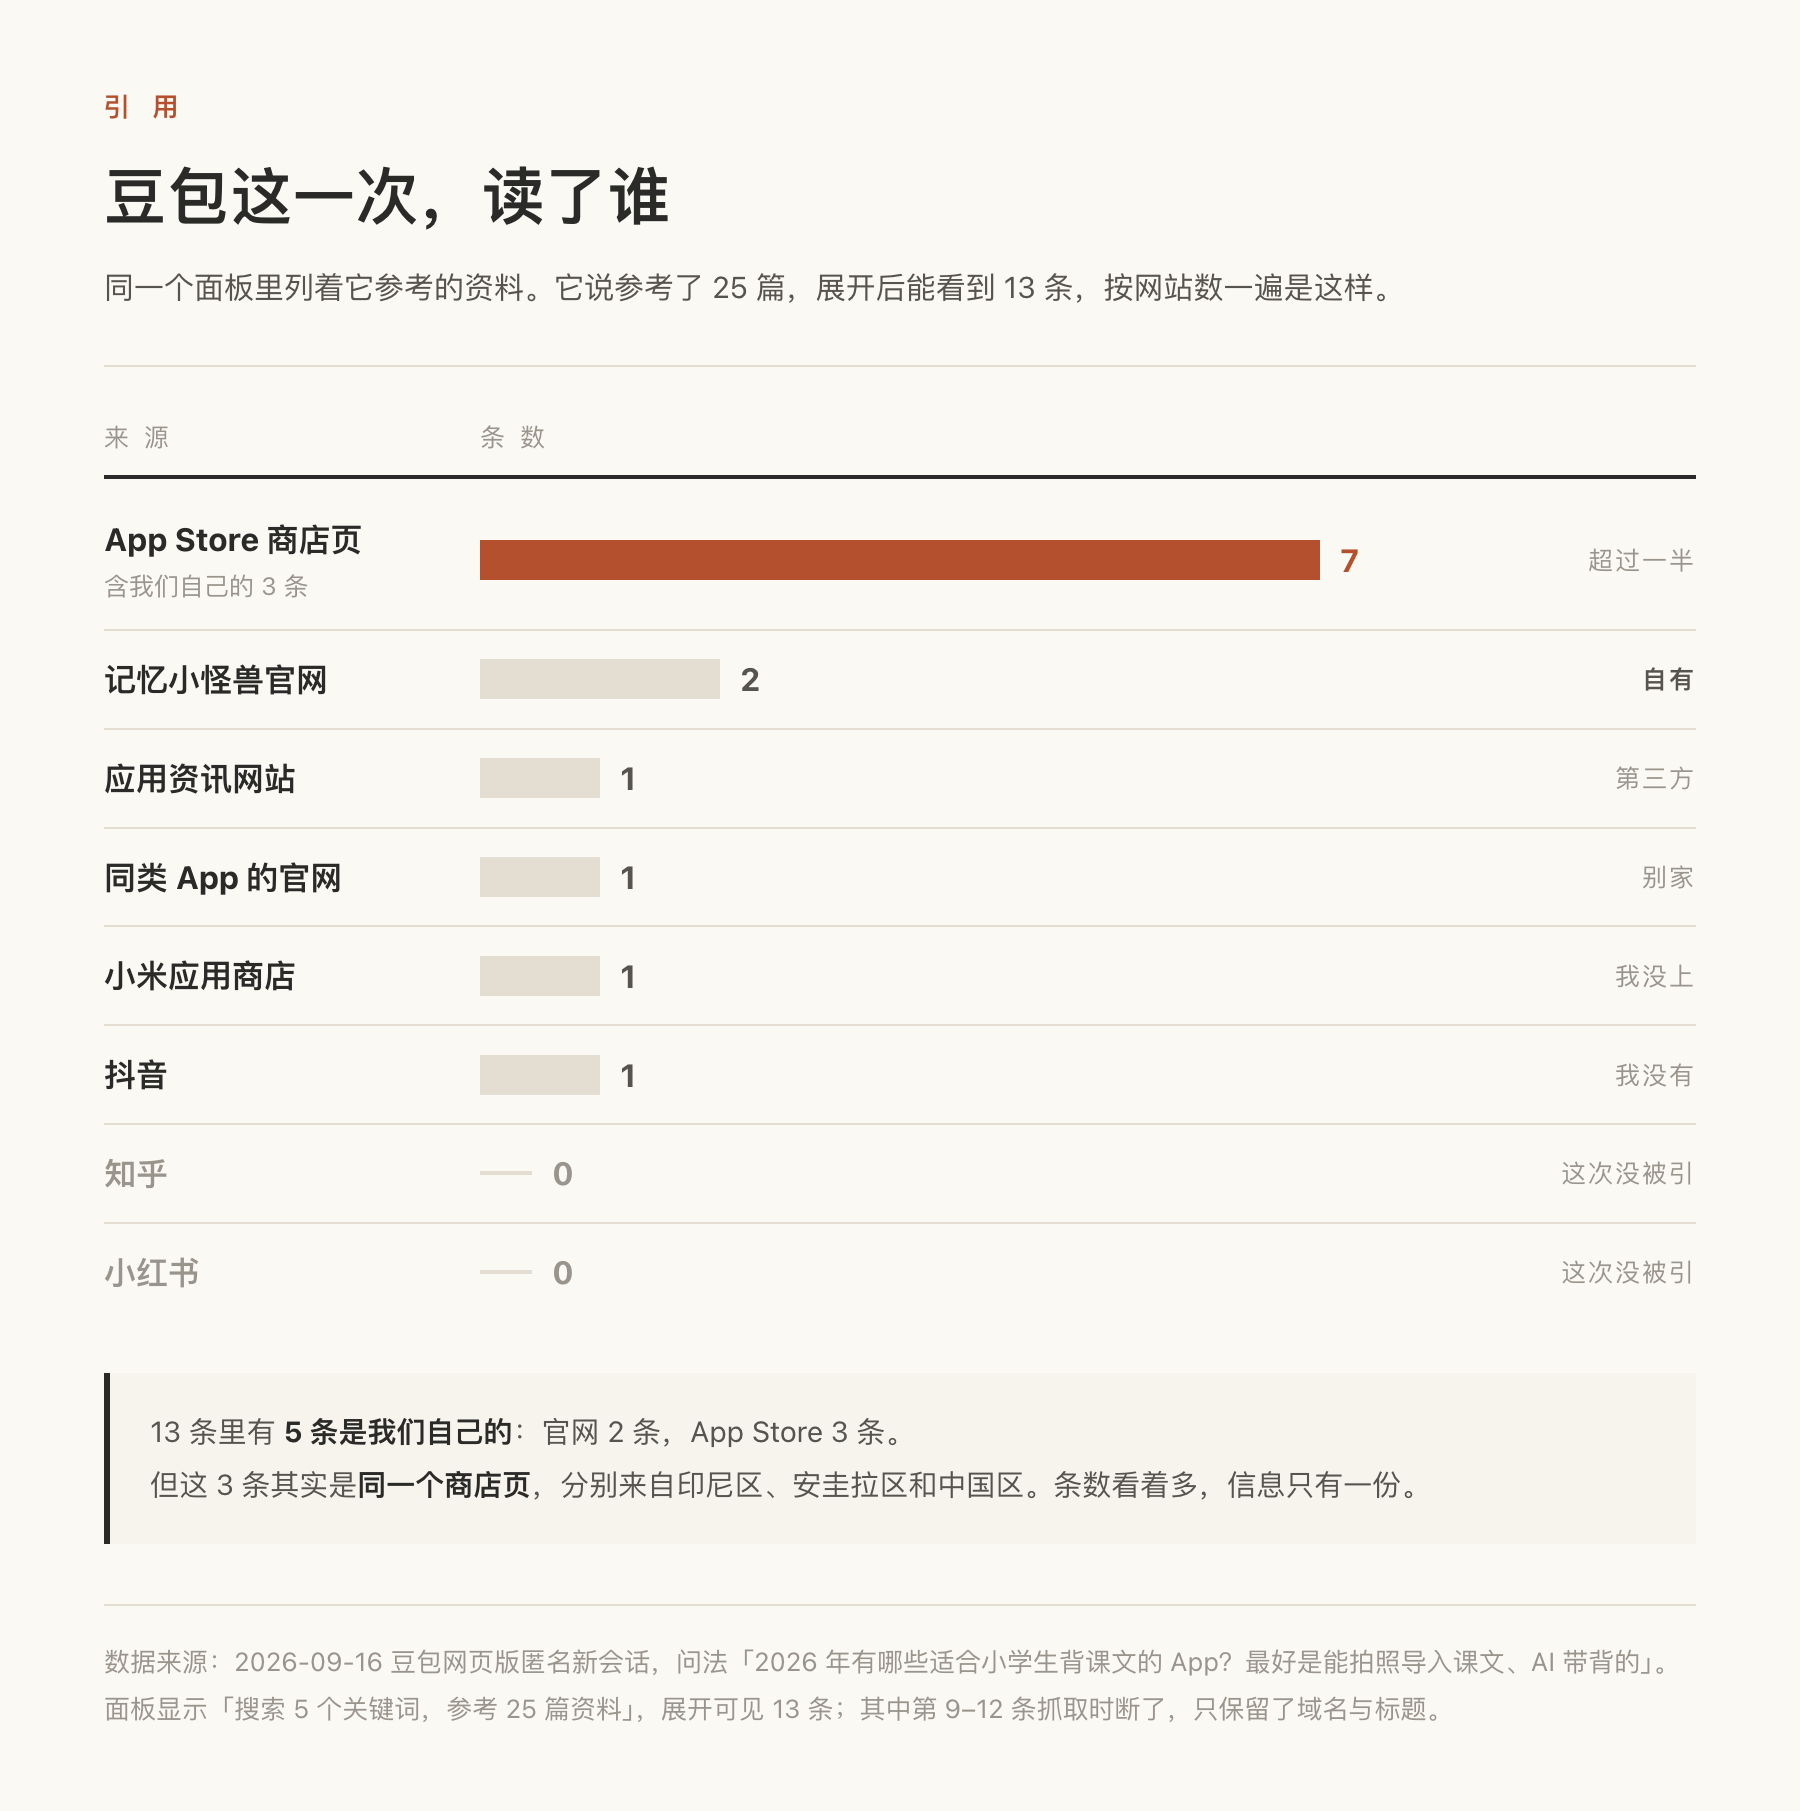 图② 13 条可见引用里,App Store 一家占了 7 条;知乎和小红书这次一条都没有
这张表里有三件事值得说。
第一,App Store 一家就占了 7 条,超过一半。这 7 条里有 4 条存下了完整链接,另外 3 条抓取时断了,只能靠标题末尾那句“App - App Store”认出它是商店页。至少在这一次,对“找个 App”这种问题,豆包读得最多的是商店页。换句话说,在这类问题上,把商店页做好(也就是常说的 ASO,应用商店优化),本身就是在做 GEO。
第二,13 条里有 5 条是我们自己的:官网 2 条,App Store 3 条。但这 3 条其实是同一个商店页,分别来自印尼区、安圭拉区和中国区(为什么会读到这几个区,我还不清楚)。条数看着多,信息只有一份。
第三,别家的 App 有从小米应用商店和抖音被读到的,这两个地方我们都没有。知乎和小红书这次一条都没被引用,但这只说明在这一个问法下是这样,不代表它们没用。
对着它读的东西,回头查自己
知道豆包读了什么,自查就有了方向。我让 Claude Code 把这几类页面挨个核了一遍,问题不少:
- 官网的修改,20 天没上线。 8 月 27 日就改好了,一直没发布到线上。线上那份写给机器读的产品说明(结构化数据),还写着 0.8.0 版、5 月 9 日更新,而应用宝上的 App 已经是 0.9.0 了。官网上专门写给 AI 看的说明文件 llms.txt,也是同样的旧信息。
- 被引用的那篇自家文章,没有任何结构化数据。 就是官网上那篇《小学生背课文,不必全靠家长陪读》,给机器读的说明一行都没有,照样被引用了。
- 中英文名字没对上。 App Store 上叫 MemoryMonster,应用宝上叫记忆小怪兽。我们用字节跳动(豆包背后的公司)的网页爬虫身份去抓应用宝页面,“记忆小怪兽”出现 28 次,“MemoryMonster”一次都没有。爬虫就是自动抓网页的程序。两个页面上没有任何一处说明它们是同一个 App。本来该由官网来说明,可官网上的这处修改,也在那批没上线的改动里。人一看就懂,机器未必。
- 安卓只上了应用宝。 华为、小米、OPPO、vivo 的商店里都没有,而别家恰好有从小米商店被读到的。
- 没有教程页。 正好对上豆包自己加的那个搜索词。
- 抖音上一条内容都没有。 这次豆包读的资料里就有抖音。
- App Store 只有 1 个评分。
也有没问题的地方:用 10 种 AI 爬虫的身份去访问官网,全都能正常打开,官网也没有拦它们。
还有一件事得老实交代。我之前做过一张监测表,打算每周去几个 AI 里把固定的问题各问一遍。翻了下记录(前面是实际问了的次数,后面是计划要问的次数):8 月 27 日 1/40,8 月 31 日 0/40,9 月 7 日 0/80,9 月 14 日 0/40,9 月 16 日 2/60,最后这 2 次就是上面那两次。表是建好了,基本没跑起来。
把问题拆成四层
查到这里,我把问题拆成了四层。一层一层看,比笼统地说“做 GEO”好下手得多:
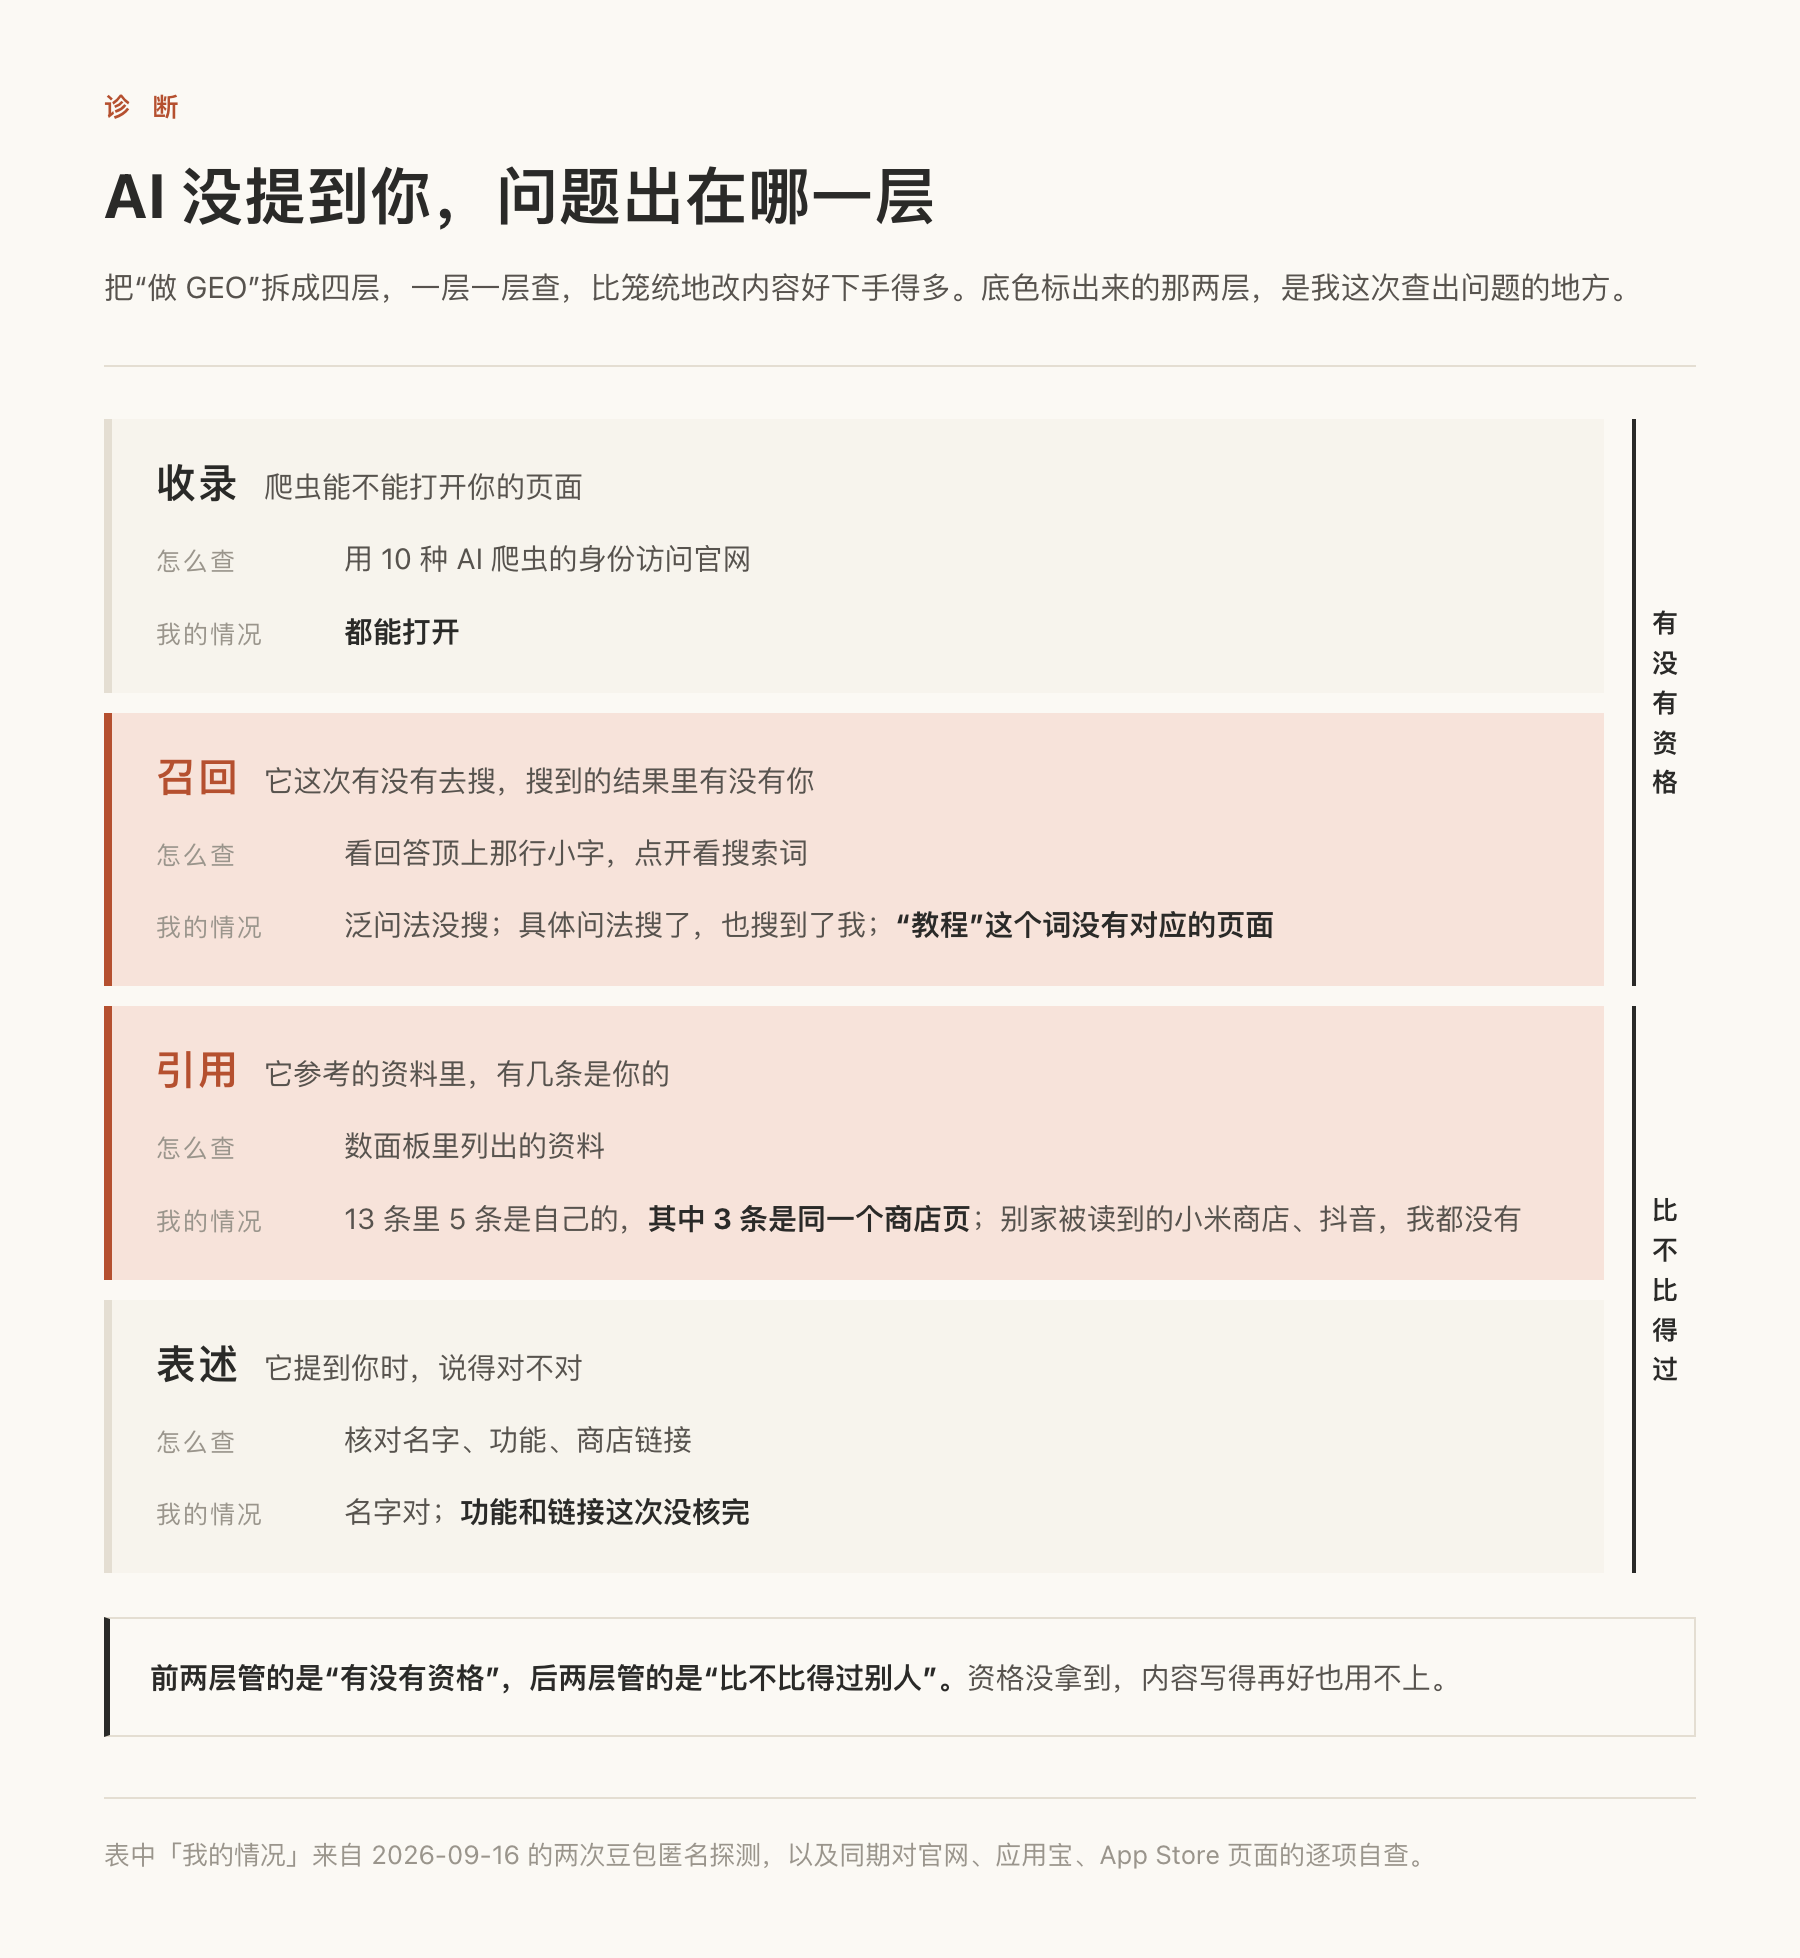 图③ 前两层管有没有资格,后两层管比不比得过;我的问题出在中间两层
前两层管的是“有没有资格”,后两层管的是“比不比得过别人”。资格没拿到,内容写得再好也用不上。我这次的问题大多出在中间两层;收录这一层没问题,暂时不用在上面花时间。
改了以后,怎么知道有没有用
这一块目前最薄弱,因为样本太少。
上面的对比,每种问法只问了一次。就算问 10 次、提到你 5 次,按统计上常用的算法(95% 置信区间),真实的提及率也可能在 24% 到 76% 之间,几乎说明不了什么。想确认“提及率从 20% 提到了 40%”,改动前后各要问大约 80 次。手动是问不过来的,我那张监测表就是证据。
所以我换了个思路:不去一遍遍问 AI,直接去查它背后的搜索。
据公开资料,DeepSeek、元宝、千问联网时,背后的搜索源分别包括博查、搜狗、夸克。智谱、博查、百度千帆这几家,都对开发者开放了搜索接口,其中智谱的接口还能切到搜狗和夸克的结果。我让 Claude Code 写了个脚本,直接调这几个接口:每周一轮,6 个问题分别查 5 个收费的搜索源,共 30 次调用,按各家的价格算大约一块钱(百度千帆在免费额度内)。
豆包原本是个缺口。今年 7 月 28 日,火山引擎(字节跳动的云服务)上线了豆包搜索服务,开发者可以通过 API 调用。按火山方舟(火山引擎的大模型平台)的文档,用它的联网搜索工具时,返回结果里会带上实际搜索用的词和引用的链接,正好是我手动点开面板看的那两样。这个接口我还没接进脚本。
要注意,接口里的豆包搜索,和豆包 App 里的回答,不一定是一回事。先拿同一批问题比一比两边的重合度,再决定信它几分。
指标我分成三个,不混在一起看:
- 搜索触发率:问了之后,豆包有没有去搜。
- 触发时的提及率:它搜了的那些回答里,有没有你。
- 自有资料占比:它参考的资料里,有几条是你自己的。
最后是下载这一头。豆包的回答里经常不带商店链接,用户看到推荐后,多半是自己去 App Store 搜的,这部分下载在后台大概率会被算进“App Store 搜索”。开头那几句判断,也是我跟用户聊出来的,不是从后台看出来的。所以 App 里最好加一个问题:“你是从哪知道我们的?”不然永远分不清。这个我也还没做。
这个土方法,别的小应用能照搬吗
能照搬的是方法:从真实的信号出发,只改一个变量去复现,点开看它搜了什么、读了谁,再对着自查。这套流程用来找原因很好用。
不要猜 AI 喜欢什么。去看它这一次搜了什么、读了谁,然后出现在它读的地方。
照搬不了的是结论。这次只有两次对比,而且只针对“找 App”这一类问法。有几个前提和漏洞得说清楚:
- 前提是平台愿意把资料来源亮出来,而且模型本来不认识你。
- 我看到的是成功的那个平台。我在 DeepSeek、Kimi、千问上也问过,都没有提到我们。
- 这个方法默认你知道用户会怎么问。最好去问问真实用户当时是怎么问的,再参考豆包给出的相关问题。
- 我测的是网页版的匿名对话,很多用户是在手机 App 里登录着问的,结果不一定一样。
一份给起步期小应用的清单
结合这次的记录,我整理了一份清单,刚起步的小应用应该都用得上:
- 先定问法。 挑具体的问题和功能词,别跟大词硬拼。
- 把商店页当成重点。 至少在“找 App”这类问题上,AI 读得最多的就是它。名字、副标题、描述、更新说明、评分和评论,都可能被读到。
- 把名字对齐。 中文名、英文名、开发者名称,在官网、各个商店、社交账号上保持一致,并在官网上写明它们是同一个 App。
- 按改写后的搜索词补页面。 每个词都要有一页能直接回答它,包括教程。
- 改完马上上线。 上线后再用爬虫的身份访问一遍,确认读到的是新内容。
- 把官网提交到各家搜索引擎的站长平台。 头条搜索、百度、搜狗、神马都有。
- 攒真实的第三方评价。 真实用户的评价、别人写的测评都算。有研究发现,AI 搜索明显更偏向第三方来源,而不是品牌自己的内容。
- 平台专属的渠道往后放。 据公开资料,豆包的资料来源包括头条和抖音,元宝包括搜狗和微信搜一搜,按你最想覆盖的平台补。
- 分三层测量。 搜索接口看有没有资格,抽查回答看说得对不对,下载来源看最后的结果。