从 Codex 到 Claude Managed Agents,Agent Harness 正在从框架变成基础设施。
两天前,OpenAI 发布了一个很容易被低估的新产品:Agents API。
如果只看名字,它似乎只是 OpenAI 又增加了一套 Agent API。但如果过去几个月你一直在研究 Codex、Claude Code,以及这些 Coding Agent 背后的 Harness,就会发现这次变化远不止如此。
OpenAI 对 Agents API 的定义非常直接:
Build and run cloud agents with the Codex harness, fully managed by OpenAI.
也就是说,OpenAI 第一次把支撑 Codex 工作的那套 Harness,作为一个托管服务直接开放给开发者。
你不再需要自己部署 Codex Harness,不需要自己维持 Agent Loop,不需要自己处理长任务中的上下文压缩,也不需要自己实现 Sub-agent 的调度。这些事情,OpenAI 开始替你做。
开发者需要提供的,变成了:任务、工具、数据、执行环境,以及自己的产品。
这看起来只是部署方式变了。但如果继续往下推,它实际上可能意味着 Agent 技术栈正在发生一次非常重要的重新分层。
一、先回到 Codex:所谓 Harness,到底是什么?
要理解 Agents API,首先得重新理解 Codex。
很多人把 Codex 理解成“一个很强的 Coding Model 加上一堆工具”。但实际上,现在的 Codex 已经远不只是“模型 + Shell”。
真正让 Codex 能连续工作几十分钟甚至几个小时、完成复杂软件工程任务的,是模型外面那一整套运行系统——Harness。
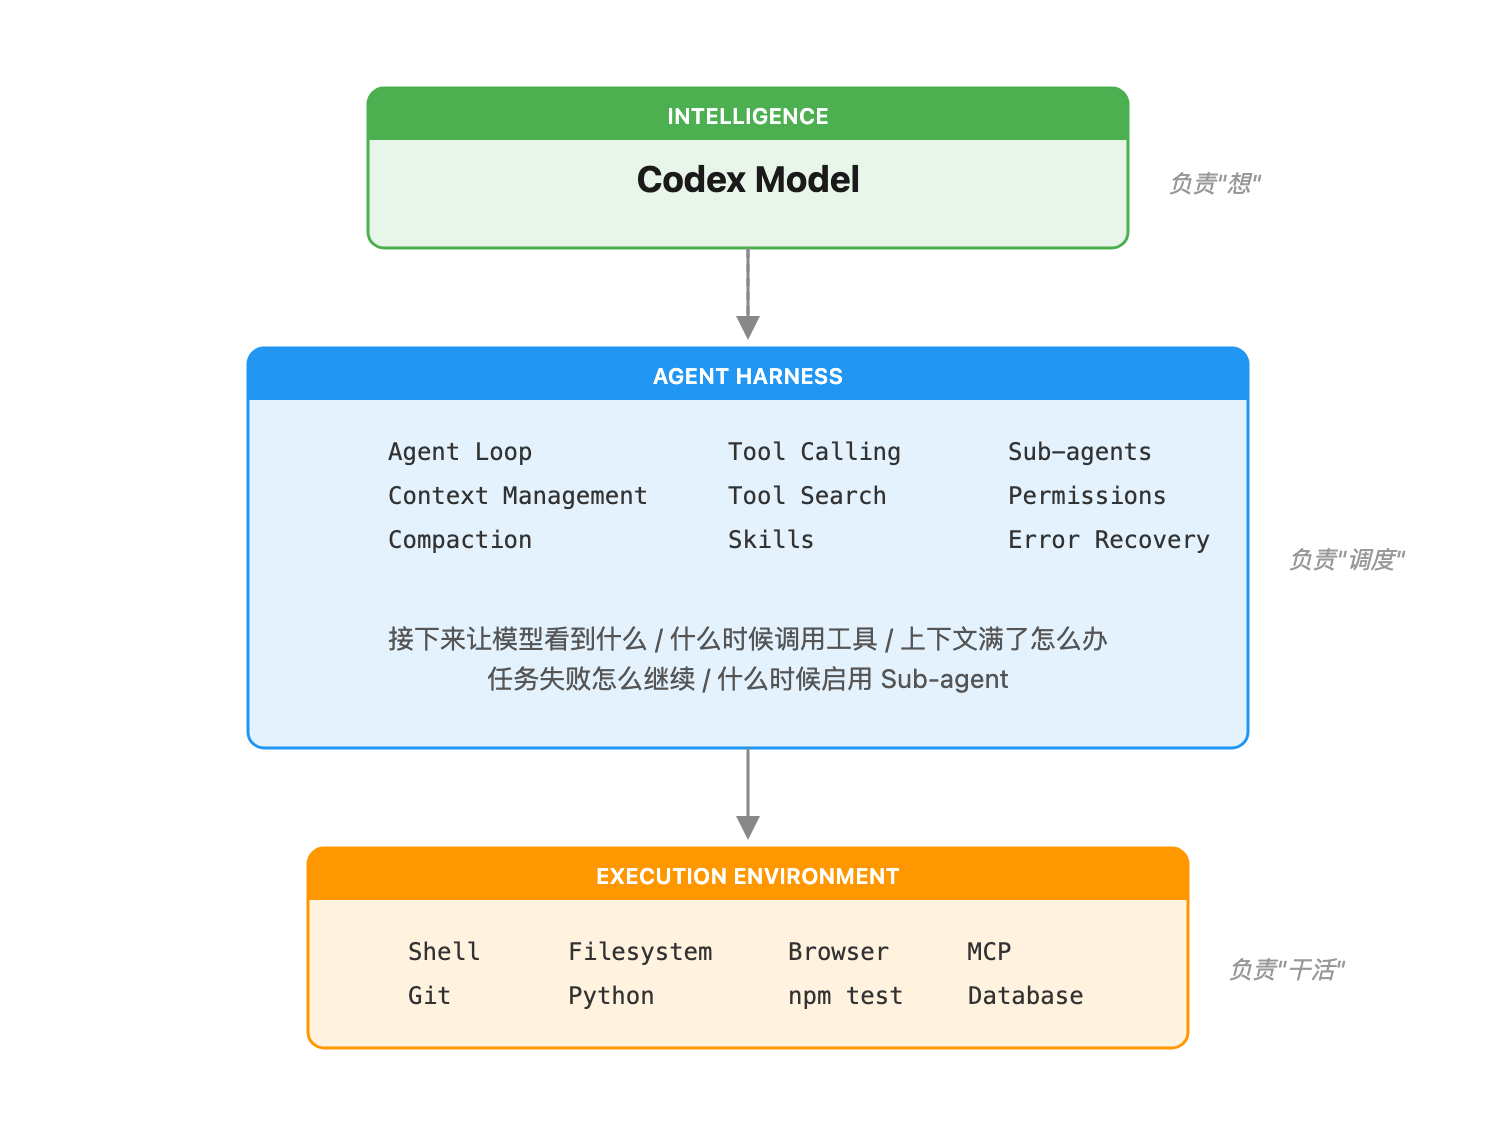 模型负责想,Harness 负责调度,Sandbox 负责干活
模型负责“想”。Harness 负责调度——接下来该让模型看到什么、什么时候调用工具、工具结果怎么塞回来、上下文快满了怎么办、任务失败怎么继续、什么时候启用 Sub-agent。而 Sandbox 或本地环境负责真正“干活”——修改文件、运行测试、执行 git、浏览网页。
过去讨论 Codex CLI、Codex SDK 和 App Server 时,其实一直在围绕这个 Harness 打转。Codex 把 Harness 开源了,开发者可以自己运行。
问题是:你得自己运行它。
二、以前使用 Codex,本质上是在“自己运行一个 Agent Runtime”
假设你想做一个自己的 Coding Agent 产品。以前的典型方案是:
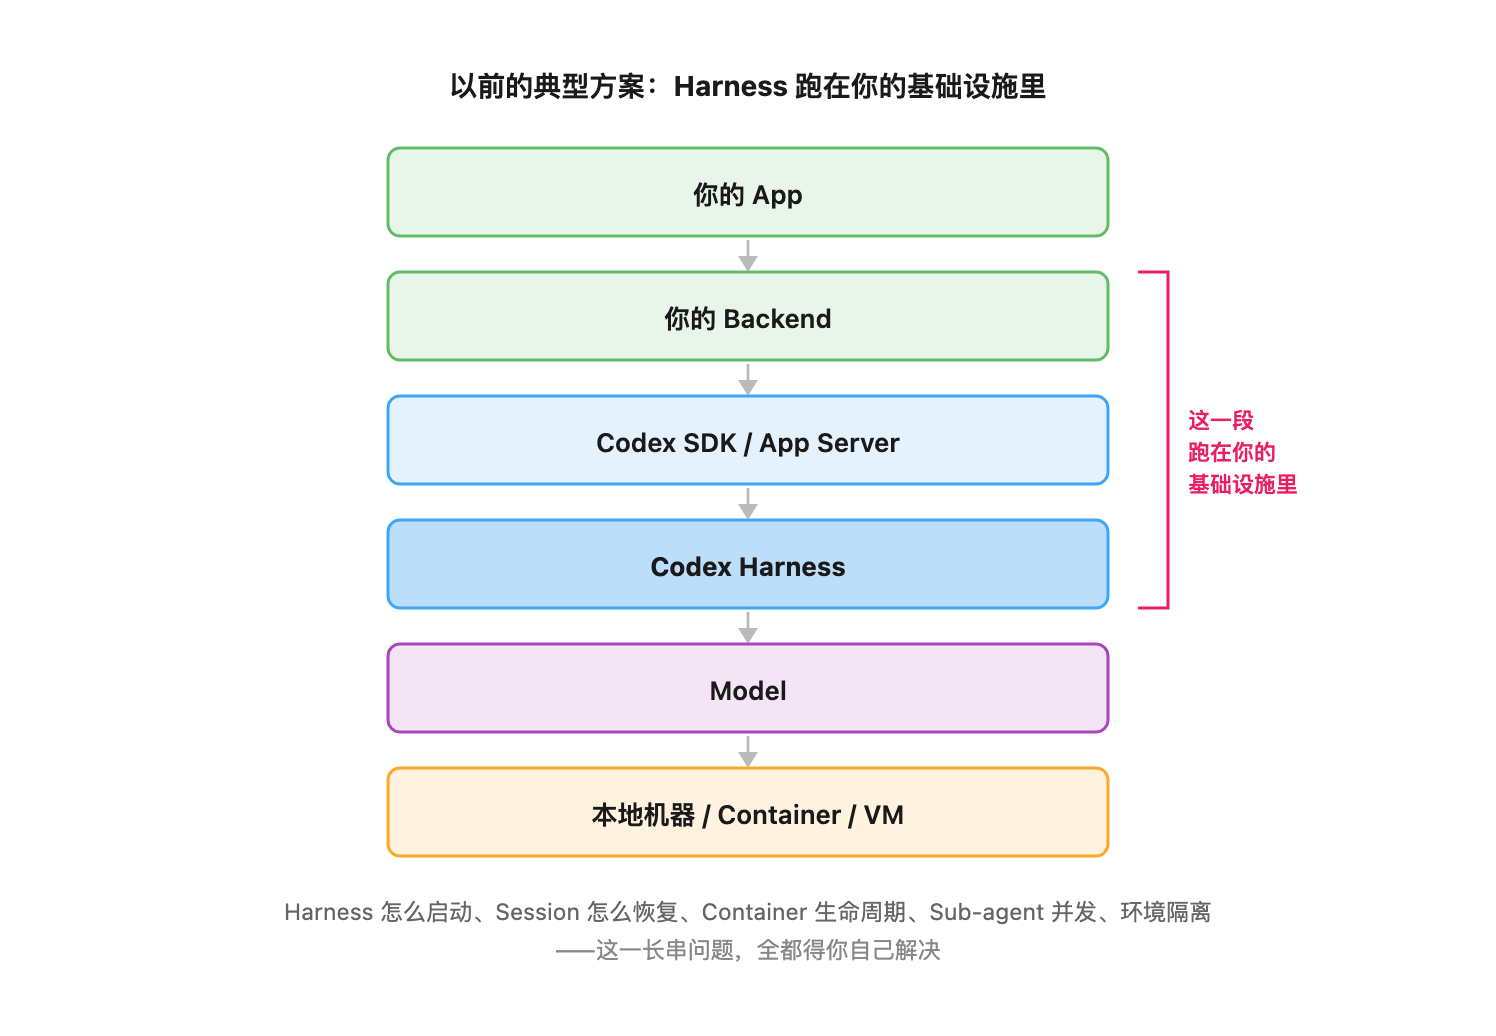 以前的典型方案:Harness 运行在你的基础设施里
虽然不用自己写 Agent Loop,但 Harness 是运行在你的基础设施里的。你还是得解决一长串问题:Harness 怎么启动?Session 怎么恢复?Container 怎么管理生命周期?Agent 长时间运行怎么恢复?Sub-agent 如何并发?环境怎么隔离?
Codex SDK 帮你解决了“怎么写一个 Agent”,但没有完全帮你解决“怎么把一万个 Agent 稳定地运行在云端”。
这两件事情并不是一个难度。
三、Agents API 改变的核心:Harness 不再运行在你这里
这次 Agents API 最重要的变化,就是 Harness 这一层发生了移动。
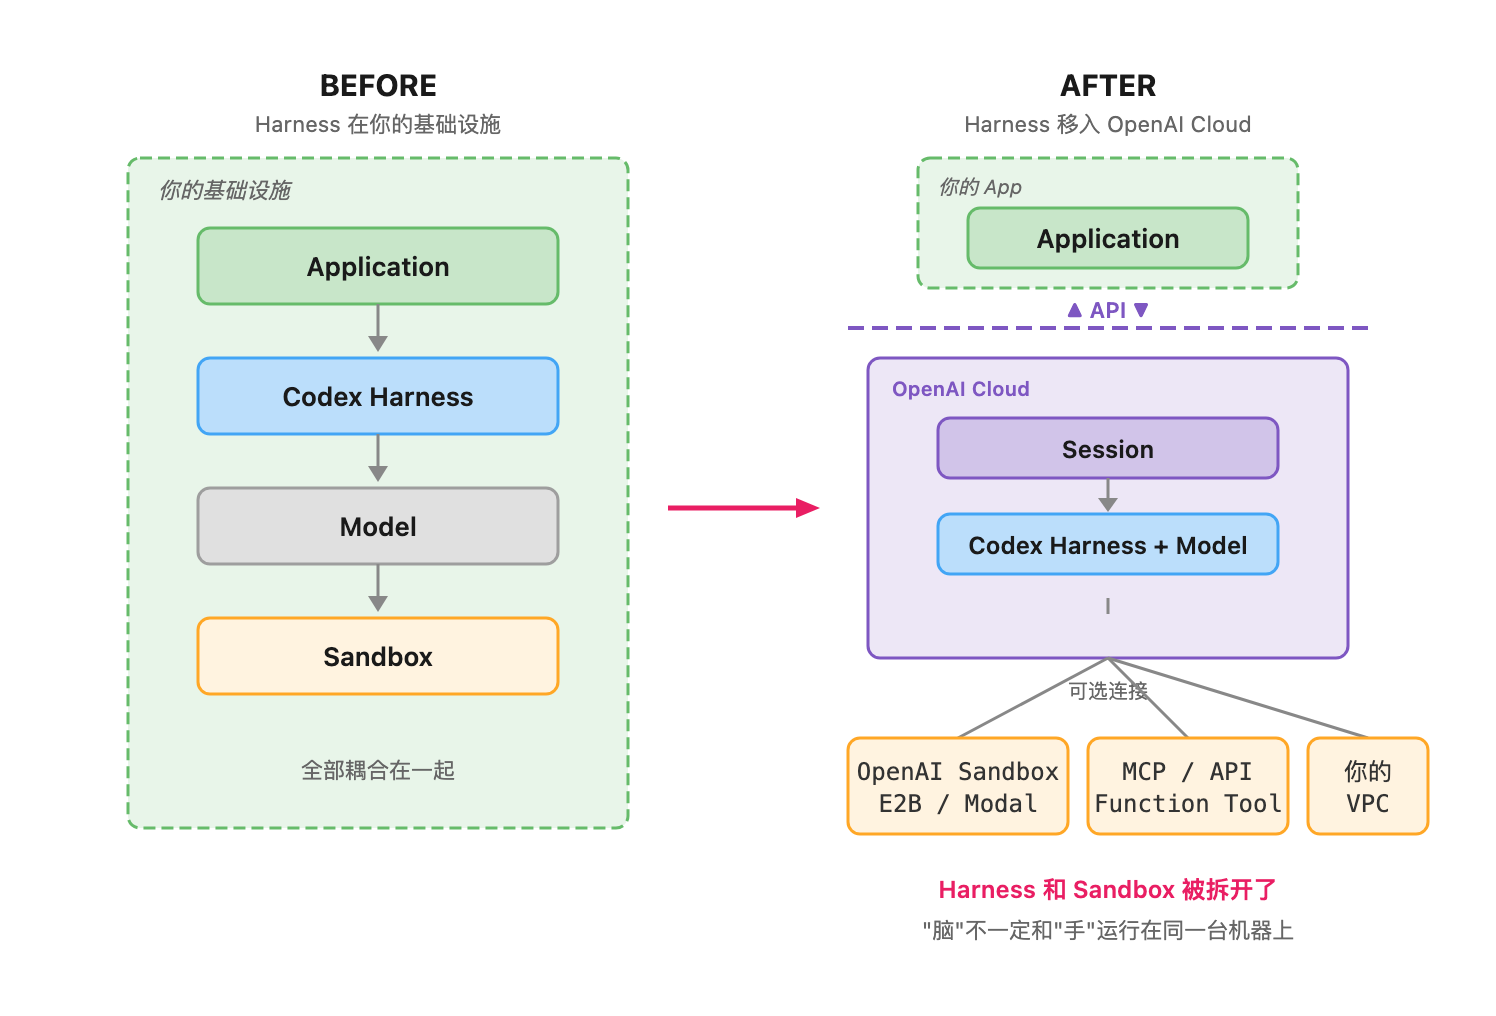 Harness 从你的基础设施,搬到 OpenAI
OpenAI 官方的描述是:OpenAI hosts and maintains the harness.
Harness 的部署、维护和演进,正式变成 OpenAI 的责任。
而执行环境仍然由开发者选择——你可以使用 OpenAI Hosted Sandbox、E2B / Modal / Cloudflare 等合作方,或者直接连接自己的基础设施和 VPC。
这也是这次架构最有意思的地方:Harness 和 Sandbox 被拆开了。 Agent 的“大脑”不一定和 Agent 的“手”运行在同一台机器上。
四、“脑”和“手”正式分离——甚至可以完全没有 Sandbox
过去 Coding Agent 最自然的实现方式是把整个 Agent 塞进一个 Container——Harness、代码仓库、Shell、工具全在一起。但这种设计很快遇到瓶颈:有些 Agent 只调几个 API,根本不需要 Container;有些 Agent 同时需要操作 GitHub、AWS、数据库、浏览器和企业内网,这些东西不应该全塞进一台机器。
更合理的架构逐渐变成:
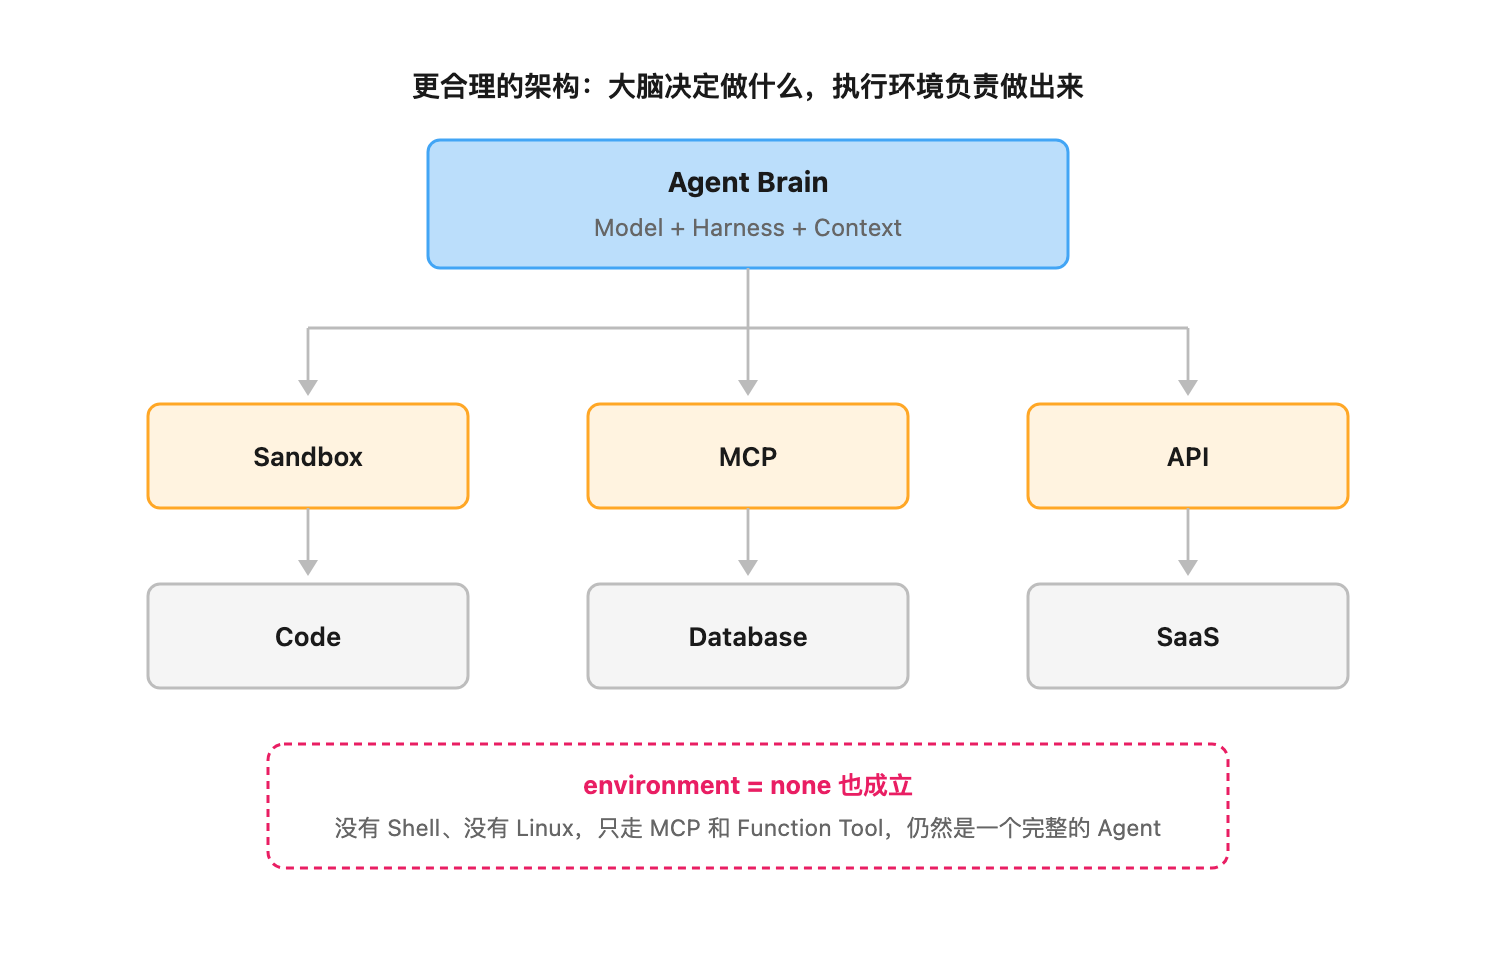 大脑决定做什么,不同执行环境负责把事情做出来
Agent 的大脑决定“做什么”,不同执行环境负责“把事情做出来”。
这里有一点非常容易被忽略:Agents API 并不等于“OpenAI 给每个 Agent 开一台云电脑”。 如果你的 Agent 不需要操作代码或文件,完全可以 environment = none,然后 Agent 只通过 MCP、Function Tool 或其他远程工具工作。
于是可能出现这样一个 Agent——用户说“帮我调查为什么昨天订单取消率突然增加”,Agent 依次查询数据仓库、调用日志 MCP、查询 CRM、查看部署记录,最后形成分析报告。整个过程没有 Shell,没有 Linux,甚至没有传统意义上的“电脑”,但仍然是一个完整的 Agent。
这意味着:Agent Runtime 正在从“运行在电脑里的程序”变成“调度各种能力的逻辑实体”。 Sandbox 只是它可以调用的一种能力。
五、OpenAI 到底替开发者托管了什么?
OpenAI 特别强调了几个 Harness 能力:
Long-running Session。 过去一个 Agent 工作两个小时,Context 快满了,你需要自己考虑哪些历史保留、哪些压缩、怎么总结、怎样继续。Agents API 会自动对早期 Context 进行 Compaction,让 Agent 持续工作。
Tool Search。 一个企业 Agent 未来可能拥有几百甚至几千个工具,不可能每次把所有 Tool Schema 塞给模型。Harness 承担理解当前任务 → 判断需要哪类工具 → 搜索并加载工具定义 → 交给模型调用的过程。
Sub-agent orchestration。 主 Agent 可以把 Deployment 分析、Error 日志分析、Dependency 分析分别交给三个 Sub-agent 并行完成。OpenAI 在官方示例里直接允许 max_concurrent_subagents: 3。
这些看起来都是“Agent 功能”,但从工程角度看,它们更像 Agent 操作系统提供的运行时能力。
六、和本地 Codex 最大的区别:从“Harness 软件”变成“Harness 服务”
以前开发者拿到的是 Harness 软件,现在拿到的是 Harness 服务。
可以类比数据库。以前你自己运行 PostgreSQL——下载安装、部署服务器、高可用、备份、升级、故障恢复。后来出现 RDS、Cloud SQL、Neon、Supabase。数据库还是数据库,SQL 没有突然发生巨大变化,但谁负责运行数据库,发生了变化。
Agents API 对 Codex Harness 做的事情非常类似。Codex Harness 仍然开源,你仍然可以自己运行。但 OpenAI 开始提供 Managed Harness。
Agent 开发者第一次真正可以选择:Self-hosted Harness,或者 Managed Harness。
七、为什么 OpenAI 要自己托管 Harness?因为 Harness 必须随模型一起变化
如果 Harness 只是一个普通软件框架,OpenAI 完全可以继续开源让大家自己跑。为什么还要专门做 Agents API?
OpenAI 给出的一个重要理由是:
利用新的模型能力,往往意味着需要重新调整 Harness;Agents API 会随着模型发布提供对应的 Harness 能力,OpenAI 会持续一起优化两者。
这句话信息量非常大。它意味着 Model 和 Harness 并不是两个完全独立的技术层。
Harness 很大程度上在弥补当前模型做不好的事情:
| 模型的短板 | Harness 的弥补方式 |
|---|---|
| 不擅长管理长上下文 | Compaction |
| 无法面对几百个工具 | Tool Search |
| 复杂任务容易丢步骤 | Task Management |
| 单模型处理太慢 | Sub-agents |
| 某些阶段容易失控 | Permissions / Guardrails |
但模型每升级一次,这些假设都可能发生变化。
八、Anthropic 四月份已经把这件事说透了
这里就不得不提 Anthropic。
今年 4 月,Anthropic 发布了一篇非常值得看的工程文章:Scaling Managed Agents: Decoupling the brain from the hands。
Anthropic 已经推出了自己的 Claude Managed Agents——同样是面向长期 Agent 工作的托管服务。
而 Anthropic 对为什么要做 Managed Agent 的解释,比“方便开发者”深得多。它们提出了一个关键判断:
Harness 中往往编码了大量关于“模型做不到什么”的假设,而随着模型能力提升,这些假设会迅速过时。
Anthropic 举过一个很有意思的例子。过去 Claude 在接近 Context Window 上限时,会产生一种 Context Anxiety——Context 快满了 → 模型觉得时间不够了 → 开始急着结束任务 → 提前交卷。于是 Harness 里需要设计 Context Reset、Summary、Checkpoint、Resume 来帮模型继续工作。但模型能力提升以后,这种行为可能改变。过去非常重要的 Harness 技巧,可能突然变成多余的复杂度。
这也是 Anthropic 为什么认为:Harness 不能被当成几年不变的固定框架,它必须和模型共同演进。
九、Anthropic 的架构拆分:Brain、Hands、Session
Anthropic 最值得看的,不是 Managed Agents 这个产品名字,而是它对 Agent Runtime 的拆分方式。
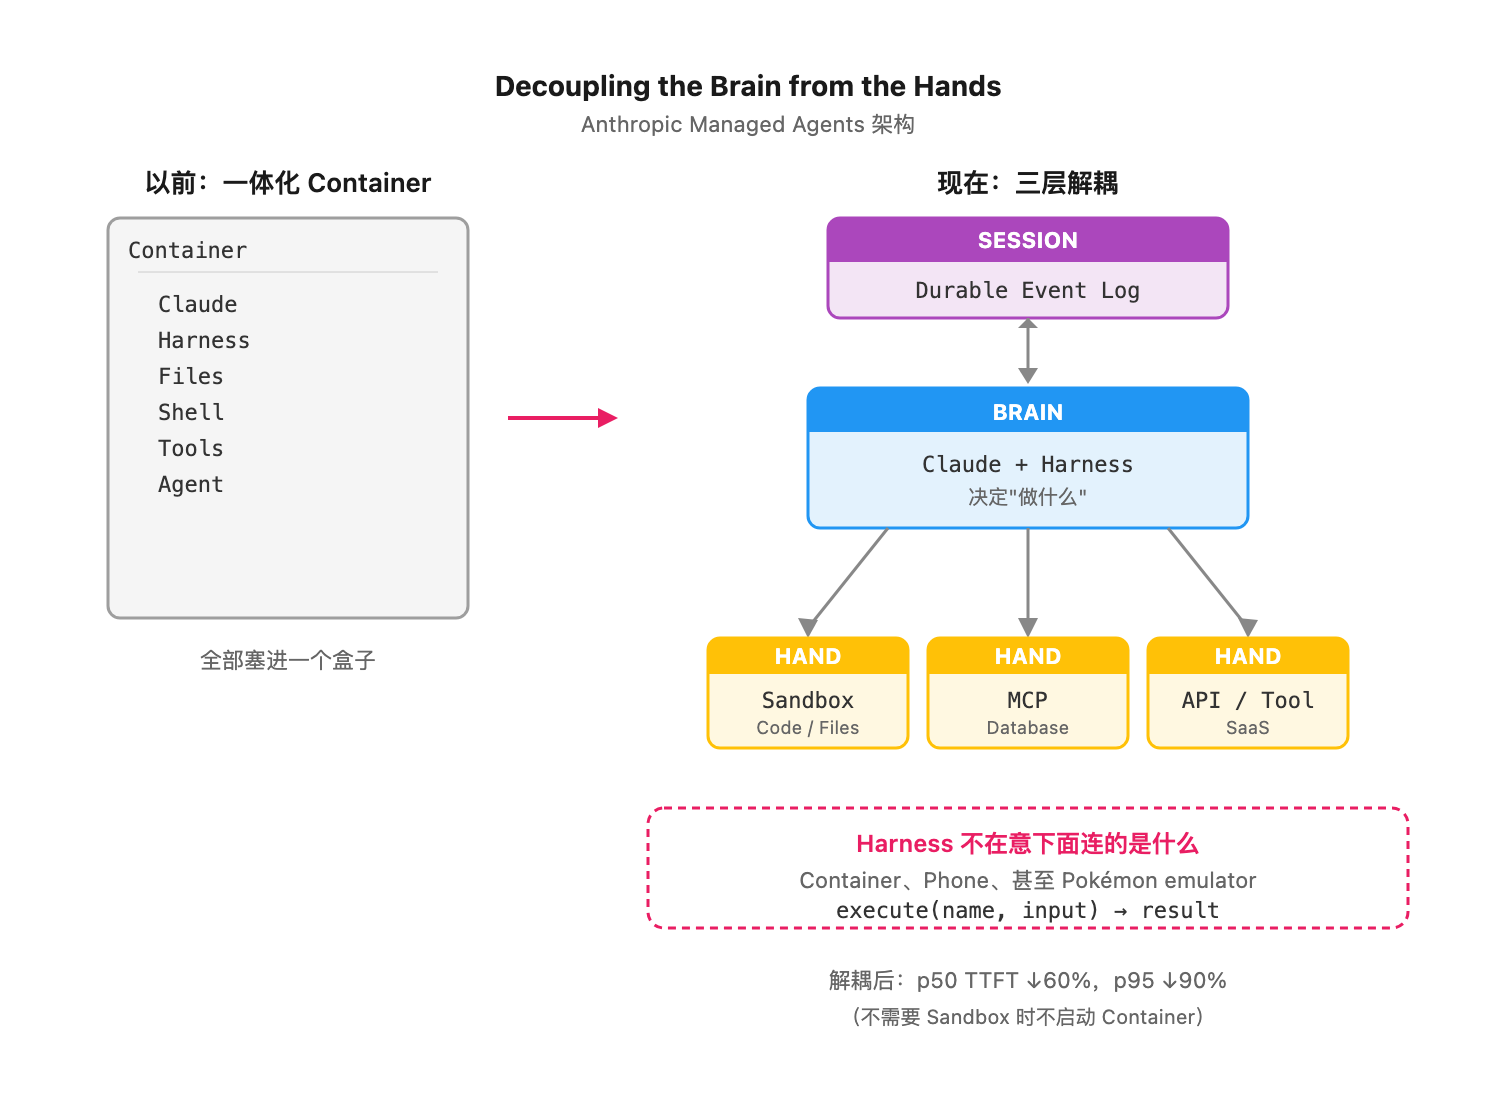 Brain、Hands、Session 三者解耦
三个部分:Brain(Claude + Harness)、Hands(Sandbox / Tools)、Session(Durable Event Log)。
然后把三者解耦——所谓 Decoupling the brain from the hands。
Sandbox 不再是 Agent 本身,它只是 Agent 可以拿起来使用的一只“手”。Anthropic 甚至说,从 Harness 的视角看,它并不在意下面连接的是 Container、Phone,还是 Pokémon emulator——只要满足 execute(name, input) → result 这样的接口即可。
这个抽象非常有力量。
而解耦带来的工程收益也很实在:不必为每个 Session 一开始就启动 Container,只有真正需要 Sandbox 时才启动。结果是 p50 TTFT 下降约 60%,p95 降低超过 90%。
十、而 OpenAI 现在正在走向几乎相同的架构
把 Anthropic 四月份的架构与 OpenAI 九月份的 Agents API 放在一起,你会发现两家公司实际上正在快速收敛。
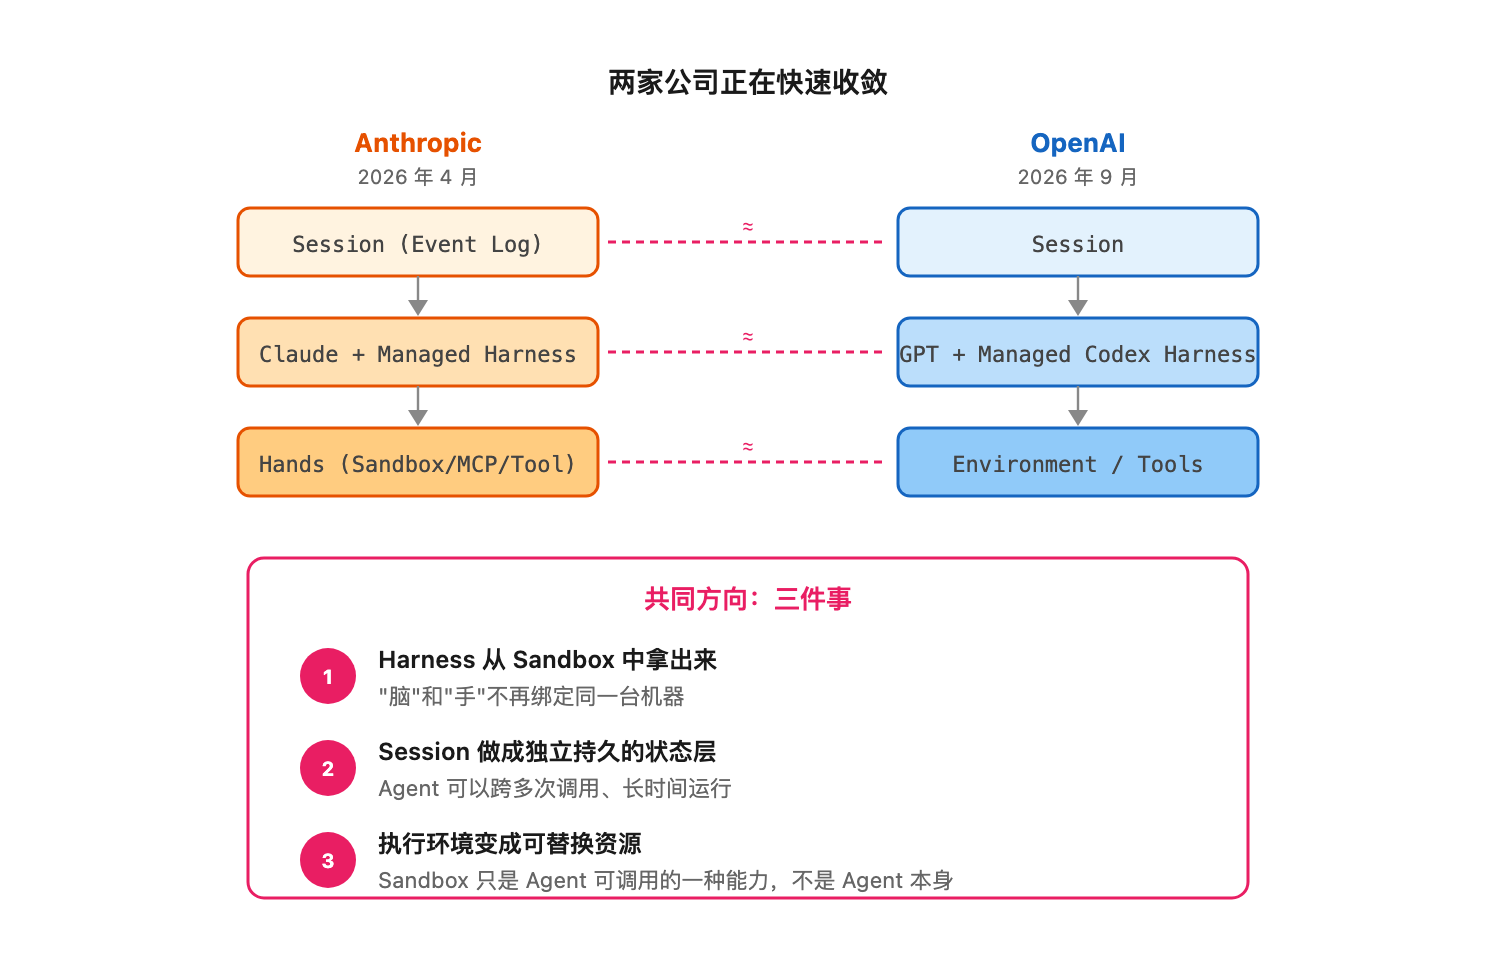 两家公司正在快速收敛
两边都在做三件事:
- 把 Harness 从 Sandbox 中拿出来。 “脑”和“手”不再绑定同一台机器。
- 把 Session 做成独立持久的状态层。 Agent 可以跨多次调用、长时间运行。
- 把执行环境变成可替换资源。 Sandbox 只是 Agent 可调用的一种能力,不是 Agent 本身。
这从侧面说明:Brain / Hands 分离不只是一个漂亮的架构图,它会直接影响 Agent 基础设施的成本和性能。
十一、Agent Harness 正在经历三个阶段的演进
如果把过去两三年的 Agent 技术放在一起,可以清晰地看到三个阶段。
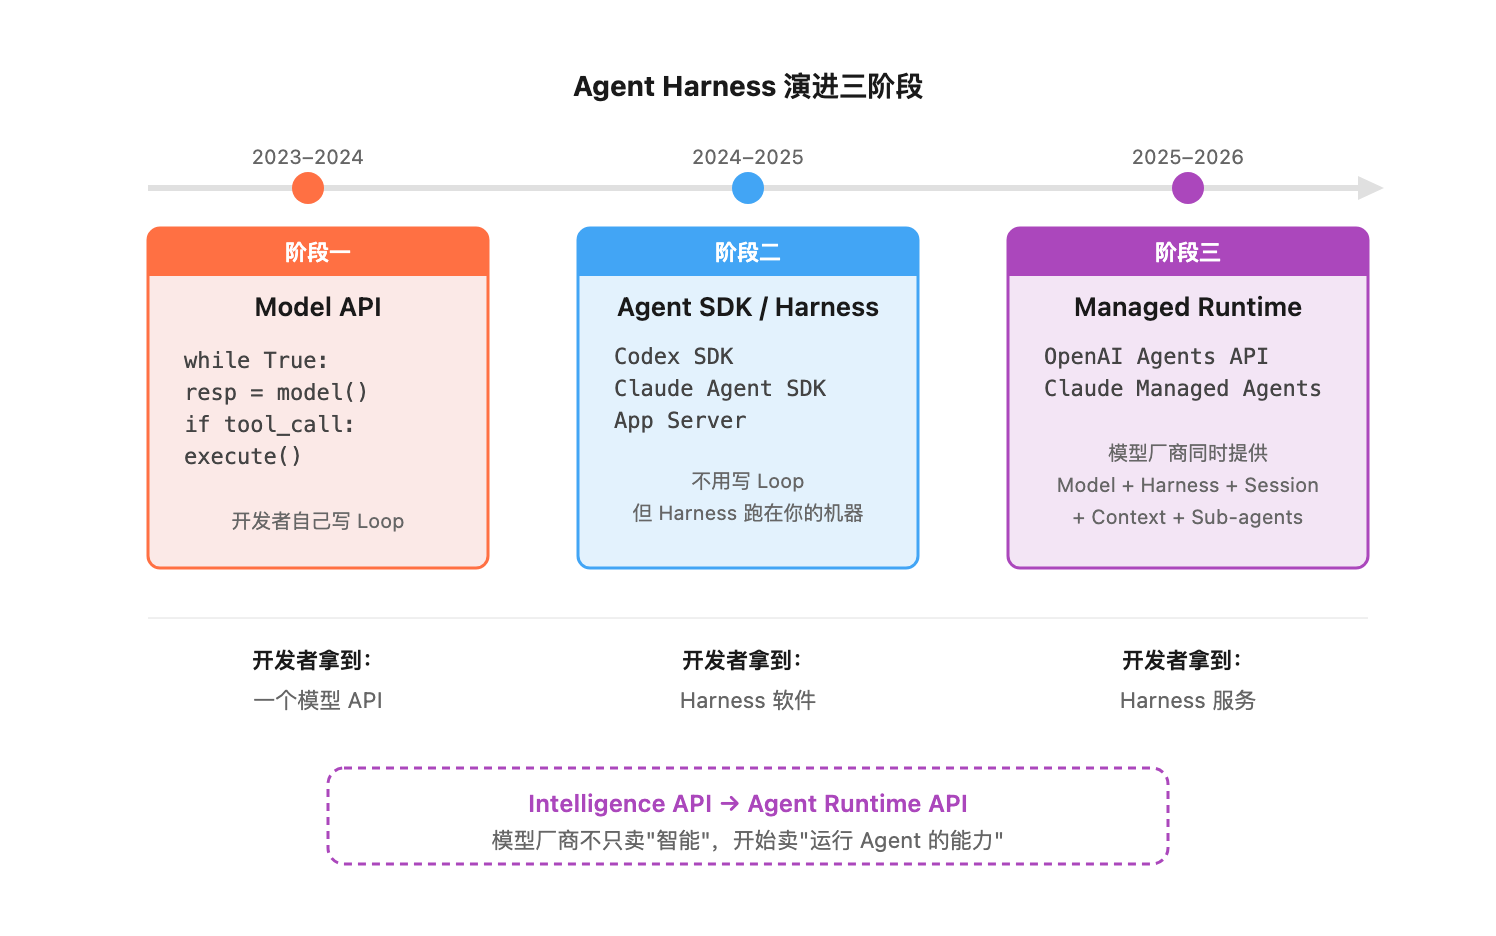 Agent Harness 演进的三个阶段
阶段一:Model API。 开发者自己写 while True: response = model(); if tool_call: execute()。大家争论的焦点是 Agent Loop 怎么写,于是出现大量 Agent Framework。
阶段二:Agent SDK / Harness。 Codex SDK、Claude Agent SDK、App Server。开发者不用从头写 Loop,但 Harness 仍然主要运行在自己的基础设施。
阶段三:Managed Agent Runtime。 Claude Managed Agents、OpenAI Agents API。模型厂商开始同时提供 Model + Harness + Session + Context Management + Tool Orchestration + Sub-agents。
开发者拿到的不再只是一个 Intelligence API,而越来越像一个 Agent Runtime API。
十二、这可能会改变 Agent 创业公司的技术护城河
这可能是这次发布最值得关注的后续影响。
过去做 Agent 产品,很多创业公司投入大量精力开发 Agent Loop、Planner、Tool Router、Memory、Context Manager、Sub-agent framework、Retry、Checkpoint。甚至很多公司的技术宣传核心就是“我们有一个更先进的 Agent Framework”。
但如果未来最强的模型厂商直接提供 Managed Harness,问题就来了:你还需要自己造多少 Harness?
假设 OpenAI 最了解 GPT-6 Astra——什么时候应该 Compact、怎样 Tool Search 效果最好、什么时候 Fork Sub-agent、什么 Prompt 结构最匹配模型。那么一个第三方团队想在“通用 Harness”这一层长期超过 OpenAI,会越来越困难。Anthropic 也是一样——最了解 Claude 的,很可能还是 Claude 的开发者。
因此 Agent 创业公司的价值重心很可能逐渐向上移动。真正重要的东西变成:Domain Data、Business Workflow、Tools、Permissions、Evaluation、UX、Integration、Distribution。
也就是:模型知道怎么工作,但你的产品决定它去哪里工作、拥有什么能力,以及什么叫“工作完成”。
十三、但 Agent Framework 并不会消失
这里不能走向另一个极端。
依然会有大量场景要求完全控制 Agent Loop、混合不同模型供应商、自己设计 Memory、严格私有部署、控制成本、构建完全不同于 Codex / Claude 的架构。这时候 Self-hosted Harness 仍然非常有价值。
未来更可能出现的是两条路线长期共存:
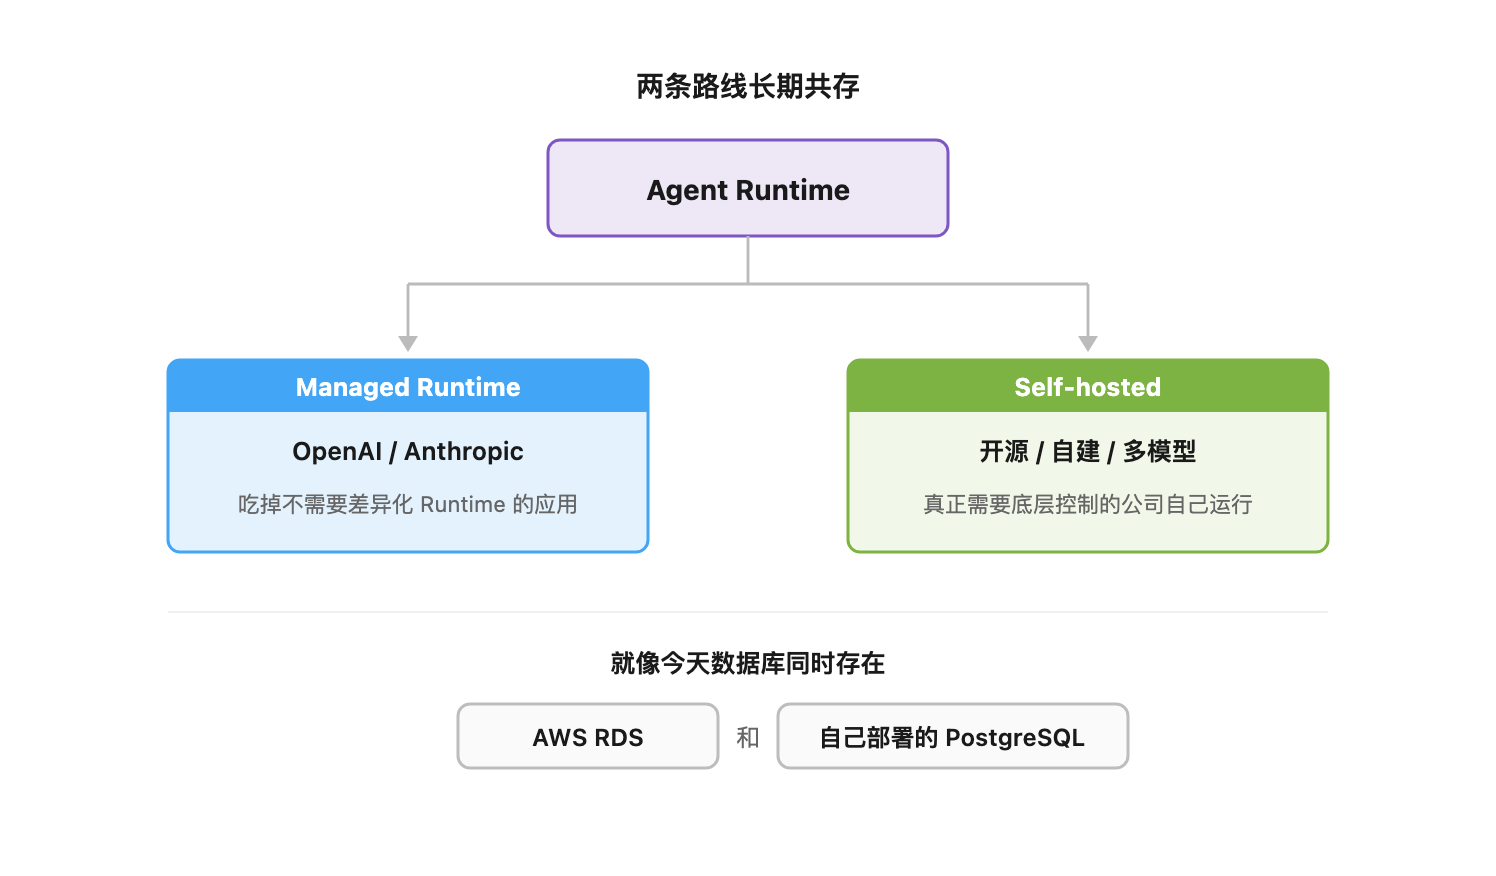 Managed Runtime 与 Self-hosted 长期共存
就像今天数据库同时存在 AWS RDS 和自己部署的 PostgreSQL。Managed Runtime 会吃掉大量“不需要差异化 Runtime”的应用,但真正需要底层控制的公司仍然会自己运行。
十四、甚至 Harness 本身可能逐渐不再是一个稳定的产品层
这是更值得讨论的一个问题。
未来很可能不是 Model + 一个长期固定的 Harness,而是 Model 每升级一次,Harness 同时升级——Tool Strategy 改变、Compaction 改变、Context Engineering 改变、Sub-agent 策略改变。甚至过去存在的一部分 Harness 功能,可能直接因为模型能力提升而消失。
这和编译器很像。开发者不会为了使用新的 CPU 指令集每次自己重新设计编译器——底层平台和编译器一起演进。Agent Runtime 可能也正在走向类似的方向。
十五、Agent Stack 正在重新分层
如果这个趋势继续,未来 Agent 技术栈可能越来越像这样:
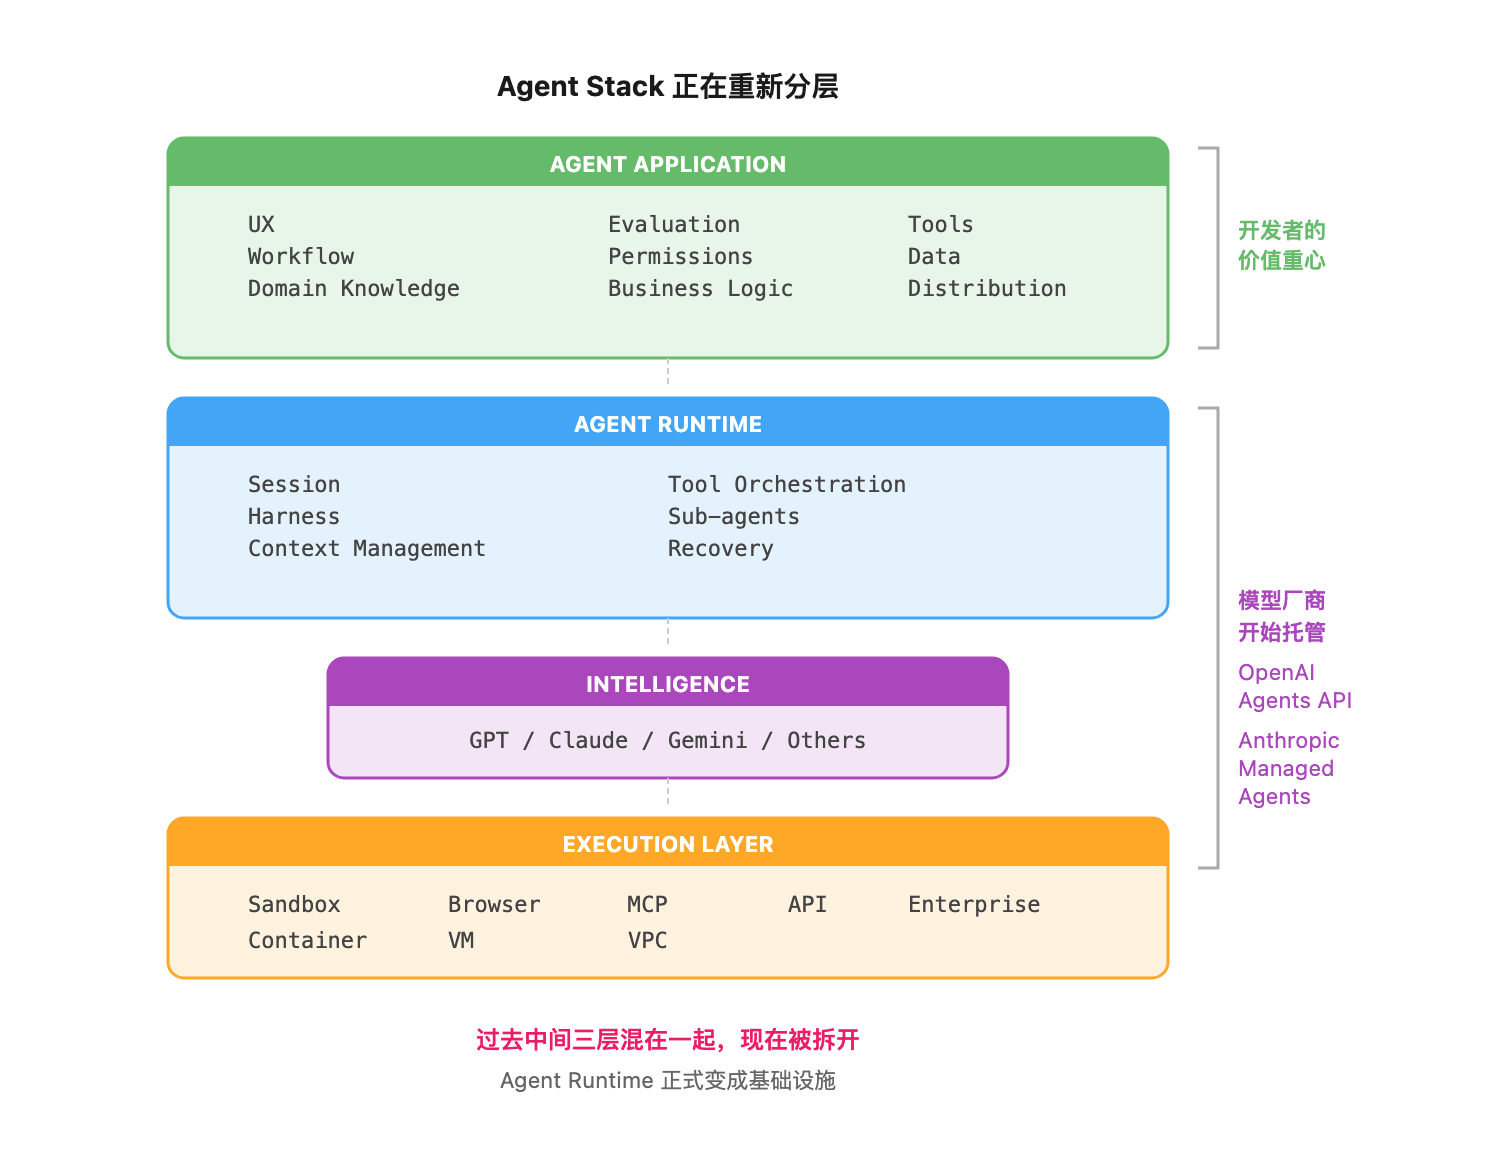 Agent Stack 正在重新分层
过去我们把中间三层经常混在一起。现在它们开始被拆开。
而 OpenAI Agents API 和 Anthropic Managed Agents 一个非常明显的共同方向就是:把 Agent Runtime 正式变成基础设施。
十六、Agents API 真正值得关注的地方
如果只从功能看,Agents API 里并没有哪一个东西是以前绝对做不到的。Session 可以自己做,Context Compaction 可以自己写,Sub-agent 可以自己调,Sandbox 可以自己起,Tool Search 也可以自己实现。
真正的变化不是 OpenAI 发明了某个新 Agent 功能,而是:OpenAI 开始把这整套东西作为一个统一、持续演进、由模型厂商维护的 Runtime 提供出来。 Anthropic 已经在做同样的事情。
所以这次 Agents API 真正值得关注的问题,并不是“这个 API 怎么调用”,而是:Agent 的基础设施边界正在被重新定义。
过去我们认为:模型厂商提供模型,开发者负责 Harness。
现在正在变成:
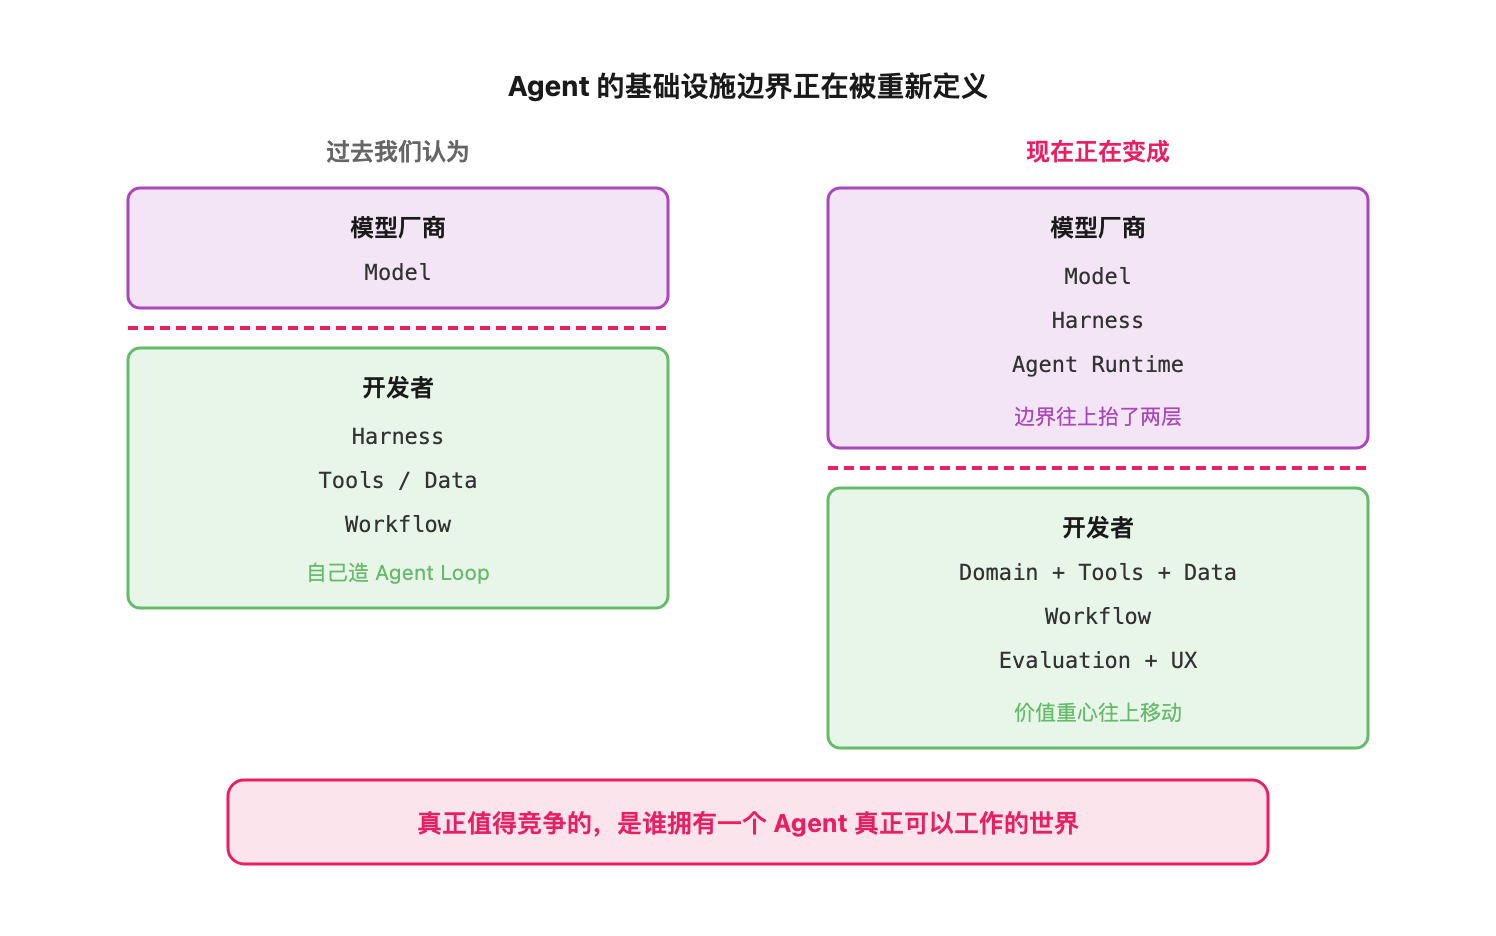 模型厂商和开发者的分工正在重新划线
如果这个趋势继续,未来 Agent 领域真正值得竞争的,也许不再是谁写出了一个更漂亮的 Agent Loop,而是——谁拥有一个 Agent 真正可以工作的世界。
数据、工具、权限、反馈、工作流、用户关系。这些东西才可能成为 Agent 应用真正难以复制的部分。
而 Harness,正在越来越像云计算时代的数据库、容器和 Runtime——它依然非常重要,但越来越多开发者,可能不再需要自己运行它。