你在 Codex 里打了一句“帮我修掉这个 bug”。
三秒后界面开始动:Thinking… → Ran grep… → Edited 3 files… → Running test… → test failed → Edited again → test passed → Done.
你只看到一个干净的 diff。但背后可能跑了几十次模型调用、十几次 shell 命令、两次审批弹窗、一轮自动上下文压缩。
这不是一个聊天机器人在回复你。这是一个完整的 Agent Runtime 在执行任务。
Codex 不是“一个模型 + 一个聊天 UI”。它是一个完整的 Agent Runtime 产品——Harness 是核心,但真正的 Codex 产品是在 Harness 外面再包了产品控制面、运行环境、UI、账户系统和云端基础设施。
而且不只是 Codex 这么跑。Claude Code、Cursor、Devin,底层全是同一个结构。
这篇文章把 Codex 从产品表面一直拆到执行内核,你拿到的不是一份产品介绍,而是一张可以套用到所有 coding agent 产品上的架构地图。
一、先吃透这张总图
OpenAI 在 2026 年 2 月把 Codex App Server 的架构讲得非常明白。下面这张图不是猜的——OpenAI 明确说:Codex CLI、IDE、Desktop App、Web 底下用的是同一套 Codex Harness;App Server 是把这个 Harness 暴露给各种客户端的标准接口。
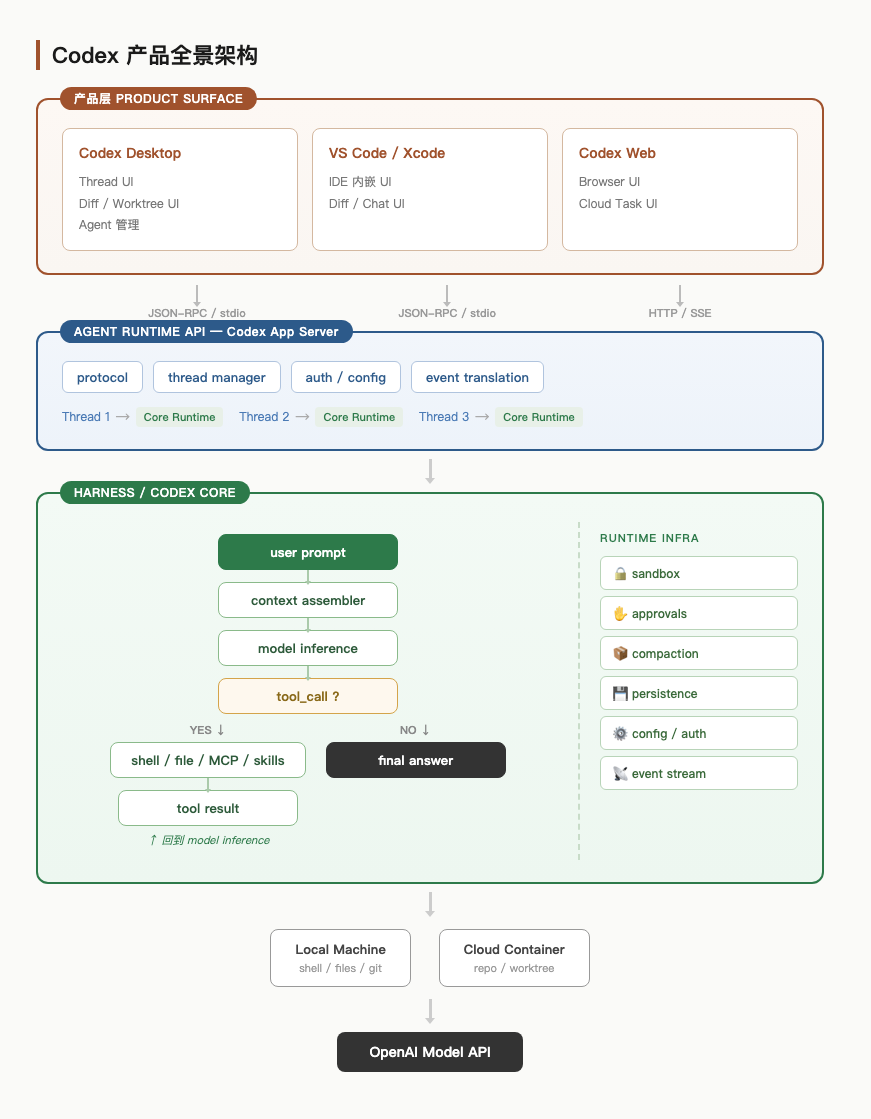 Codex 产品全景架构
三大块:最上面是产品层(你看到的各种 UI),中间是 Agent Runtime API(App Server,负责把各种 UI 接进来),最下面是 Harness / Codex Core(真正干活的 Agent 内核)。
看明白这张图,后面所有拆解都有锚点。
二、把它抽象成六层——可以套到所有 Agent 产品上
总图是 Codex 具体的实现。但如果我们要对比 Claude Code、Cursor、Devin,需要一个更通用的框架。
我把所有 coding agent 产品拆成六层:
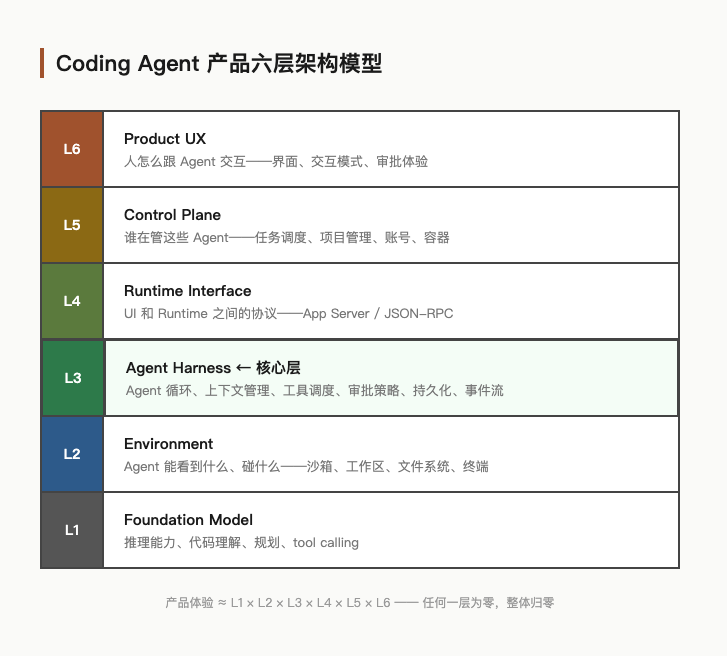 Coding Agent 产品六层架构模型
下面从底往上,逐层拆。每一层我都会讲清楚:它解决什么问题、Codex 怎么做的、精妙在哪。
三、L1 Foundation Model——模型不等于产品
最常见的误解:
“Codex 就是用了 GPT 最强的编码模型嘛。”
Codex 产品和 Codex 模型是两回事。模型决定的是“看懂代码 + 规划 + 生成 patch”的能力——推理力、tool calling 的质量、长任务的连贯性。
但模型一次 inference 结束,它什么都不会“做”——不会打开文件,不会跑测试,不会 git commit。模型只是给出了一个“下一步干什么”的决定。
真正让事情发生的,是 L3 的 Harness。 这也是为什么理解 Codex 不能只看模型,得看整个产品。
四、L2 Execution Environment——最被低估的一层
Agent 如果只调用模型,什么都干不了。它必须拥有一台 computer:能读文件、写文件、跑 shell、git diff、npm test、打开浏览器。
Agent = Model + Computer
而 Harness 的工作,就是控制“模型怎么使用这台 computer”。
Codex 的环境层是所有 coding agent 里最完整的
本地模式下,Codex 给命令执行套了多平台沙箱——macOS 用 Seatbelt,Linux 用 Landlock / bubblewrap,Windows 有独立的 Codex sandbox。这不是锦上添花,是产品可用的前提:Agent 决定跑 rm -rf / 的时候,沙箱是唯一的防线。
云端模式下,Codex 为每个任务开一个独立容器,里面有完整的 repo checkout、依赖安装、独立的 shell 和 git 环境。
再加上 Worktree 隔离(后面会展开),Codex 在 L2 这一层搭了一套完整的“Agent 能安全操作的隔离工作空间”。
这层决定 Agent 能力的上限
日志能不能看到?测试能不能跑?浏览器能不能打开?这些不是模型能力的问题,是环境能力的问题。
让应用、日志、指标、测试环境都变成 Agent 可以直接观察和验证的对象,会显著增加 Agent 的实际能力。同一个模型,在不同产品里表现差距巨大——环境差了一层,能力就差一截。
五、L3 Agent Harness——这里才是真正的核心
先纠正一个概念
很多人把 Harness 理解成 prompt + agent loop + tools。实际上 Codex 的 Harness 比这大得多——它是一个 Agent Runtime Kernel。
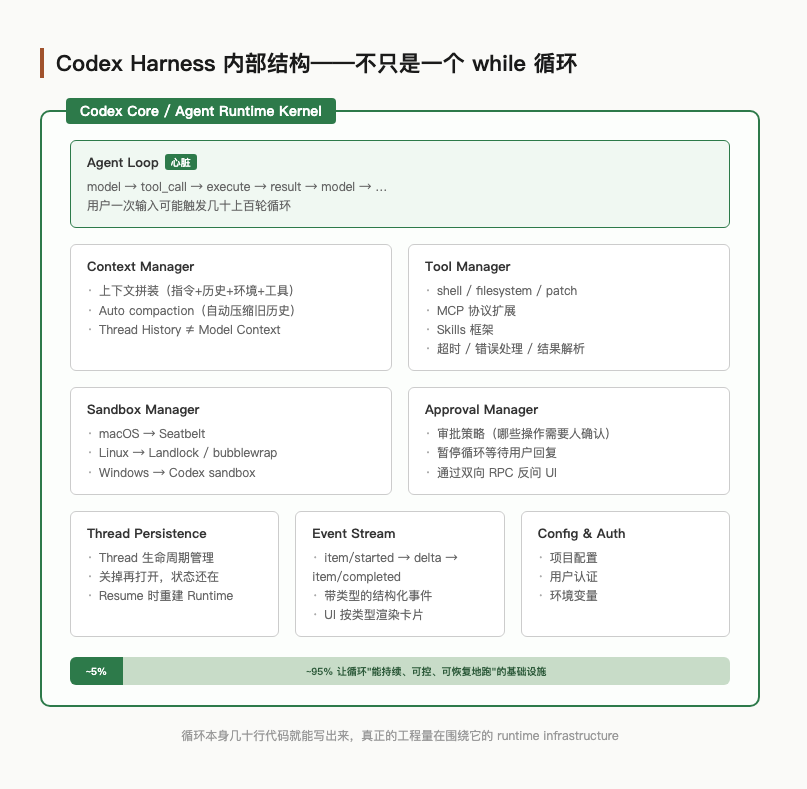 Codex Harness 内部结构
循环只占 Harness 大约 5%。剩下 95% 是让循环“能持续、可控、可恢复地跑下去”的基础设施。
Agent Loop 本身其实很简单
假设用户输入“帮我检查登录 bug 并修复”。真正发生的不是 prompt → GPT → response,而是一个反复循环:
模型返回一个 tool_call → Harness 执行工具 → 结果追加到上下文 → 再调模型 → 模型又返回一个 tool_call → ……直到模型不再返回 tool_call,给出最终回复。
用伪代码写只有几行:
while True:
    response = model(context)
    if response.tool_call:
        result = tools.execute(response.tool_call)
        context.append(response)
        context.append(result)
    else:
        return response
这里有两个很多人问过的问题:
一次任务会调用几次模型? 可能几十次,甚至几百次。用户输入一句话叫一个 Turn,一个 Turn 里 model → tool → model → tool 的循环可能跑非常多轮。
谁在决定“再请求一次模型”? 不是模型。是 Harness。模型返回 tool_call,Harness 执行完工具、拿到结果、拼回上下文、再喂给模型——这个“再来一轮”的决定权,在 runtime 手上。
但真正困难的不是这个循环
Agent loop 本身几十行就能写出来。真正困难的是围绕它的一整套 runtime infrastructure:
- Context Manager:历史太长了怎么办?哪些该留哪些该压缩?
- Tool Manager:几十种工具怎么注册、路由、超时、错误处理?
- Sandbox Manager:这条命令能不能跑?权限边界在哪?
- Approval Manager:哪些操作要人类确认?确认期间整个循环暂停等人
- Thread Persistence:关掉 app 再打开,Agent 跑到哪了?
- Event Stream:怎么把循环里发生的每一件事实时告诉 UI?
- Recovery:网断了 / 崩了 / 模型超时了,怎么恢复?
Context Management——Thread 历史 ≠ 模型上下文
一个长任务的 Thread 可能积累了几十个 Turn、上百个 Tool 调用。但模型的上下文窗口有限,不可能每次都把完整历史全塞进去。
Codex Core 里有一个 Context Manager,它负责把 Thread 的完整历史裁剪成“实际送给模型的上下文”:
- System instructions + AGENTS.md
- Skills 定义
- 环境信息(目录结构、git 状态)
- 旧历史的压缩摘要(经过 auto compaction)
- 最近几轮的完整记录
- 当前用户请求
- Tool 定义
当上下文接近窗口上限时,Codex Core 自动触发 auto compaction——把早期历史压缩成摘要,腾出空间给新操作。
Thread History ≠ Model Context
完整历史是 Thread 的,模型每次看到的只是经过 Context Manager 裁剪和压缩后的一个窗口。做 Agent Runtime 必须记住这句话。
六、Thread / Turn / Item——最值得学的数据模型设计
这是 Codex API 最精妙的抽象。它没有用传统聊天的 conversation → message,而是设计了三层结构:
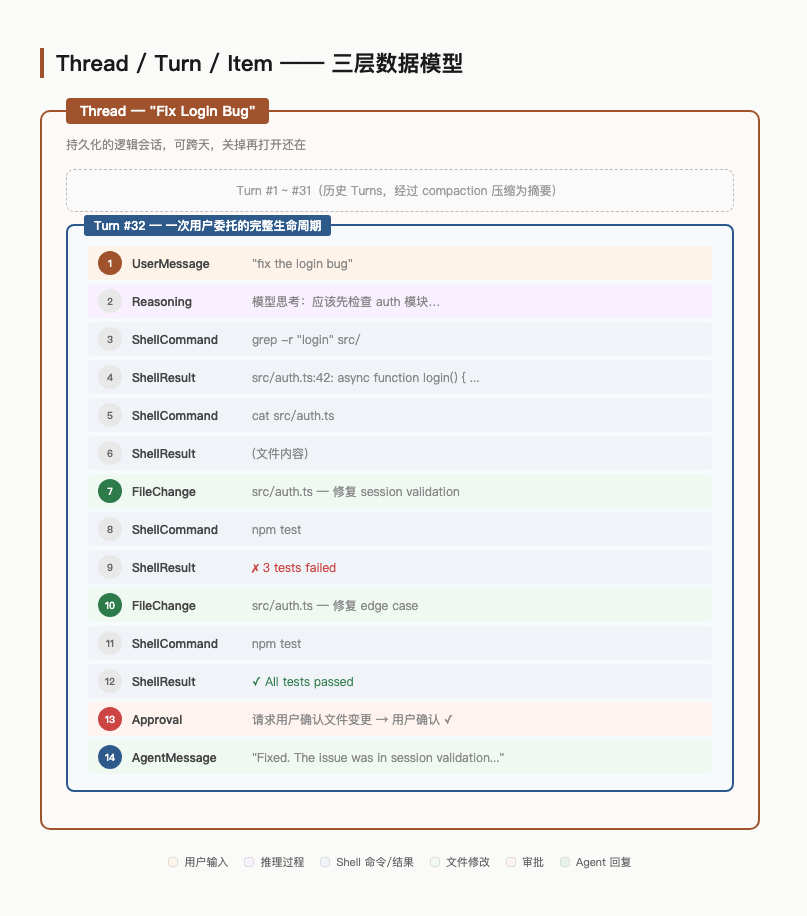 Thread / Turn / Item 三层数据模型
- Thread = 一整个持续的 Agent 会话。可跨天,关掉再打开还在,可以继续追问
- Turn = 一次用户委托的完整生命周期。从“fix the login bug”到“Fixed.”,中间可能包含几十轮 model ↔ tool 循环
- Item = Turn 里面发生的每一件具体的事。每个 Item 有明确的类型:UserMessage / Reasoning / ShellCommand / ShellResult / FileChange / Approval / AgentMessage
这就是为什么 Codex UI 可以显示 Thinking… / Ran grep… / Edited 3 files… / Running test… —— 它不是在解析一大坨文本猜发生了什么。Runtime 本身就在发带类型的结构化事件,UI 按类型渲染对应的卡片。
这也是为什么你的数据模型不能只建一张 messages 表。Agent 执行过程中产生的东西——shell 命令、文件修改、审批记录、子 Agent 调用——用 message 根本无法表达。如果你一开始就用 messages 表,后面要拆的时候会发现改数据模型比重写还难。
七、L4 App Server——最漂亮的一层设计
问题:多个 UI 怎么办?
最早 Codex 只有 CLI,直接调用 Harness。后来又做了 VS Code 插件、Desktop App、Web 版、Xcode 插件。难道每个 UI 都自己实现一遍 Agent?
所以 OpenAI 抽出了 App Server——Harness 的 API 层,所有 UI 通过统一协议接入。
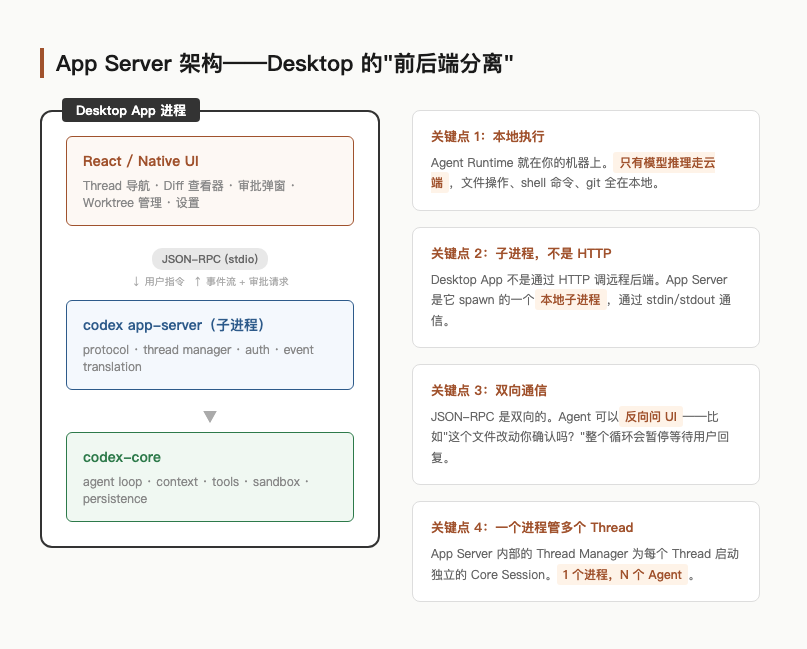 App Server 架构
四个关键设计点:
1. 本地执行,不是远程调用。 Desktop 模式下,App Server 是桌面应用 spawn 的一个本地子进程,通过 stdin/stdout 通信。Agent Runtime 就在你机器上,只有模型推理走云端。
2. 子进程 stdio,不是 HTTP。 这不是传统的“前端调后端 REST API”。Desktop App 和 VS Code 都会把经过验证的 Codex binary 一起打包发布,启动时拉起 App Server 作为长驻子进程。
3. 双向通信。 JSON-RPC 是双向的——Agent 可以反向问 UI。比如要执行危险操作时,Harness 通过 App Server 发 approval/requested 给 UI,弹出确认框,整个循环暂停,用户点确认后才继续。这是 Agent 产品和聊天产品在交互模型上的根本区别——聊天是单向请求-响应,Agent 是双向协作。
4. 一个进程管多个 Thread。 App Server 内部的 Thread Manager 为每个 Thread 启动独立的 Core Session。一个进程,N 个 Agent 并行。
八、完整跑一次真实任务
现在把所有层串起来。你输入“帮我找到登录失败的原因并修复”,从头到尾发生了什么:
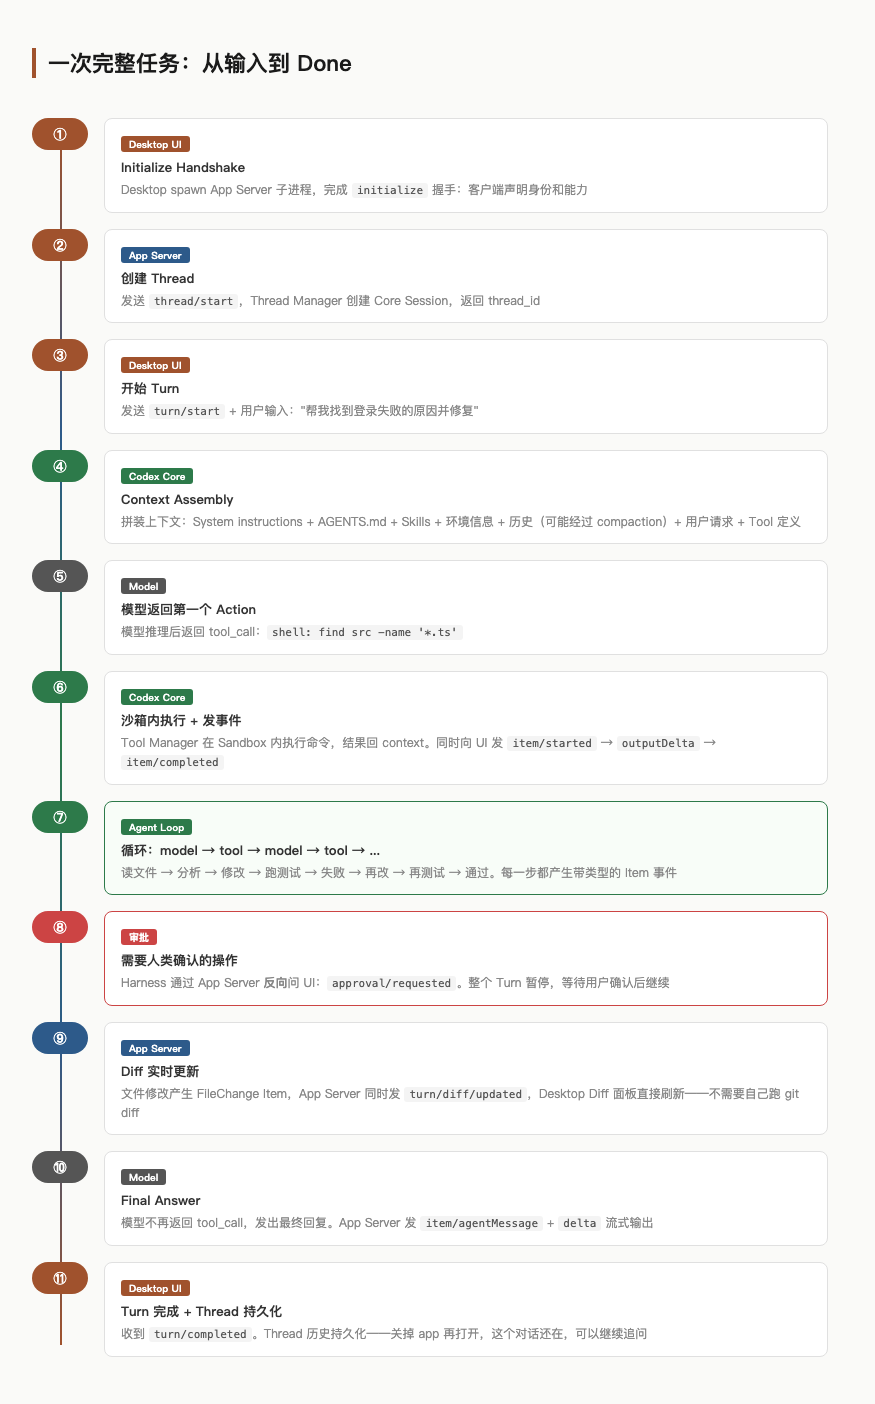 一次完整任务流
注意第 ⑥ 步和第 ⑧ 步。
第 ⑥ 步:Runtime 全程向 UI 发 结构化事件——item/started → outputDelta → item/completed。UI 显示“Ran grep…”“Edited 3 files…”,不是在解析文本猜发生了什么,是 runtime 告诉它的。
第 ⑧ 步:审批是双向的。Harness 通过 App Server 反向问 UI,整个 Turn 暂停等待用户回复。这不是一个“只会往前跑”的脚本——它知道什么时候该停下来让人做决定。
九、Thread vs Runtime——搞清这个才能理解持久化
Thread = 持久的逻辑会话(durable logical conversation)
Runtime = 当前正在运行的执行状态(currently instantiated execution state)
它们的关系:Thread 持久化在磁盘 → App 关闭 → Runtime 消亡 → App 重新打开 → thread/resume → 新的 Runtime 从持久化状态重建。
Thread 可以在 Runtime 消亡后存活。这正是为什么 persistence 属于 Harness 的职责——它不只是让循环跑起来,还要让循环跑到一半时能暂停、能恢复。
另一个细节:logical runtime ≠ OS process。 App Server 是一个进程,内部管理多个 Thread 的 Core Session。一个逻辑 Runtime 不一定对应一个物理进程。
十、Worktree 隔离——多 Agent 并行的工程前提
假设你在 Codex Desktop 同时开了三个 Agent 任务:修登录 bug、写 API 文档、修 CI。如果它们直接改同一个 workspace——三个 Agent 同时改同一个文件,必炸。
所以 Codex Desktop 让每个 Agent 使用独立的 git worktree,不会互相污染,也不会弄乱你当前的 Git 状态。
Thread 是逻辑概念,Worktree 是物理隔离。中间有一层 Workspace Binding 决定“这个 Thread 在哪个 worktree 里干活”。这个设计让多 Agent 并行从“理论上可能”变成了“工程上可行”。
十一、Desktop vs Cloud——完全不同的架构
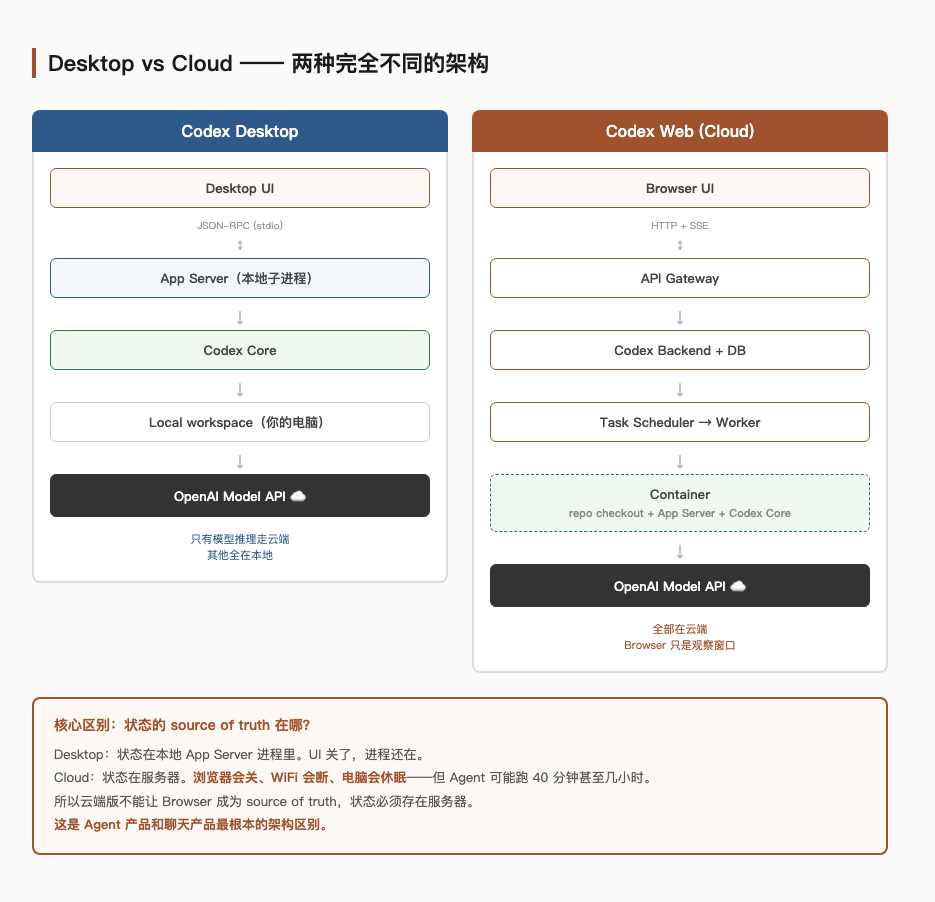 Desktop vs Cloud 对比
核心区别在一个问题:状态的 source of truth 在哪?
Desktop 模式下,状态在本地 App Server 进程里。Cloud 模式下,状态必须在服务器——因为浏览器会关、WiFi 会断、电脑会休眠,但 Agent 可能跑 40 分钟甚至几小时。
所以云端版的 Browser 只是一个可以随时断开、随时重连的观察窗口。这是 Agent 产品和聊天产品最根本的架构区别。
云端版实际上分成了两个 Plane:
- Control Plane:用户管理、任务调度、容器生命周期、权限、计费、通知
- Execution Plane:模型推理、agent loop、工具执行、沙箱、文件 / git 操作
以后看任何 Agent 产品,先问:它的 Control Plane 和 Execution Plane 分开了没有?这是成熟度的标志。
十二、开源 / 闭源分界
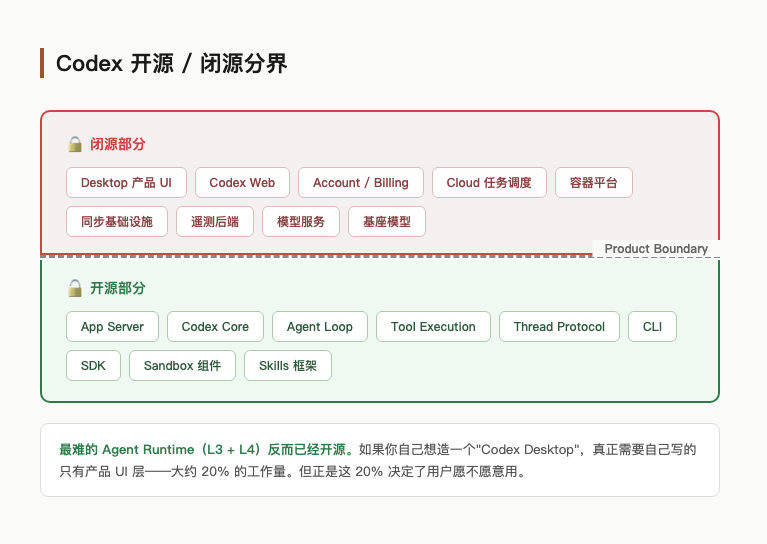 开源闭源分界
最难的 Agent Runtime(L3 + L4)反而已经开源了。 如果你自己想造一个“Codex Desktop”,真正需要自己写的只有产品 UI 层——大约 20% 的工作量。App Server 和 Codex Core 可以直接用。
但正是这 20% 决定了为什么 Codex 是一个好用的“产品”,而不仅仅是一个 CLI Agent。Thread 导航、Diff 查看器、审批弹窗、Worktree 管理——这些都是把“能跑”变成“能用”的东西。
十三、护城河在哪?
如果只看 agent loop——护城河真的不大。几十行就能写出来。
但 Codex 真正的质量是一个乘法:
产品体验 ≈ 模型 × Runtime × 上下文 × 工具 × 环境 × 产品 UX
六项里任何一个变成零,整个体验都会崩。
“Harness 不重要,护城河全在模型”——2024 年可能对,2026 年已经不对了。模型能力当然占最大头,但当模型足够强以后:
- Runtime 质量决定模型能不能持续做事——auto compaction 做得差,跑几轮上下文就爆了;中断恢复做得差,网一断任务就废了
- 环境可观测性决定模型能验证什么——没有测试环境的 Agent 永远不知道自己改的对不对
- 产品 UX决定人类能不能驾驭它——worktree 隔离、diff 审查、审批控制,决定了用户敢不敢真的让 Agent 干活
十四、用这张六层图看其他产品
以后你再看任何 coding agent 产品,不要先问“用了什么模型”。先画六层,看它在每一层怎么做的。
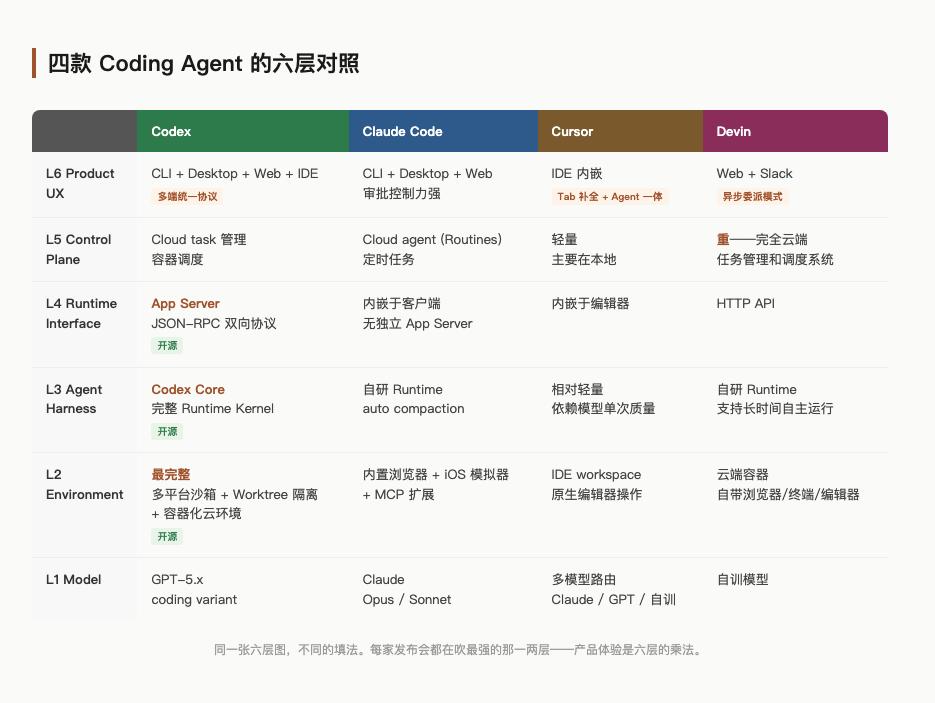 四款 Coding Agent 的六层对照
几个值得注意的差异:
Codex 最重的投入在 L2 + L3 + L4——环境隔离、Runtime Kernel、App Server 协议。 它的策略是把 Agent 的“操作系统”做到最完整,然后通过统一协议接各种 UI。L3 和 L4 大量开源,这是它最独特的产业位置。
Claude Code 在 L2 做了不同方向的投入——内置浏览器和 iOS 模拟器。 Agent 可以自己打开网页截图验证、在模拟器里跑 app 看效果。它没有独立的 App Server 层,Harness 直接内嵌在客户端里,走的是 SDK 集成路线。
Cursor 的核心差异在 L6——把 Agent 嵌进了 IDE 编辑器本身。 Tab 补全和 Agent 任务共用一套上下文。你不用切窗口,Agent 就在你写代码的地方。L3 相对轻量,更多靠模型单次推理质量 + 极好的上下文注入。
Devin 重注在 L5——完全云端的任务调度系统。 你在 Slack 里给任务,关掉电脑,明天来看 PR。这种“异步委派”模式下,Control Plane 的完善度(进度跟踪、通知、状态管理)比实时交互的 UX 更关键。
同一张六层图,不同的填法。 每家发布会都在吹自己最强的那一两层。但产品体验是六层的乘法——某一层做到极致,另一层为零,乘出来还是零。看懂这张图,你就不会再被任何 Agent 产品的发布会忽悠了。