“我该学 LangChain 还是 OpenClaw?”想做 Agent 的人几乎都问过这句,或者它的某个变体。
这两样根本不在一层:一个是你写代码时调进来的库,一个是装在电脑上、自己会动手干活的成品。
会把它俩摆在一起挑,不怪问的人。几乎所有教程都是同一个排法:第一章提示词,第二章上框架,第三章带你搭个能演示的东西。照着走完,demo 是能跑的,你还是说不出这两样差在哪。
框架不是第二步。第二步是你自己把那个循环写一遍,总共二十行上下。
写过一次,所有框架你都看得懂它在包哪一段。没写过就去挑,你只是拿一个看不进去的黑盒,换了另一个看不进去的黑盒。
这不是我一个人的看法。Anthropic 工程博客那篇《Building Effective Agents》给开发者的第一条建议就是先直接调模型 API,理由很直白:框架多包的那层抽象会遮住底下真正发出去的提示词和收到的回复,出问题时更难查。
中文这边 2026 年好几份 Agent 学习路线,开头也都写着“别一上来就选框架”,往下翻到动手的部分,第二章还是框架教学。嘴上说的和排的课,是两回事。
下面这条路分四段,从最浅走到最深。
一、先用现成的,把一件真活干完
这段最没争议,所以也最容易被急着学技术的人跳过。
要攒的是对能力边界的手感:Agent 在哪一类活上稳定好用,在哪一类活上稳定不行。手感只能靠干真活攒,看教程攒不出来。
这一层现在不用费劲挑。市面上这批东西界面长得各不相同,内核是同一个:装上就能直接干活,该怎么一步步往下推、能调哪些工具、哪一步要不要先问你一声,全都替你内置好了,你只负责把规则写清楚。这篇里我统一管它们叫工作台。
差别只在冲着谁做。你手上的活是代码和文件,就用 Claude Code、Codex 这一类。你手上的活是文档、表格、汇报,Anthropic 的 Cowork 今年 2 月做成了企业版,5 月又把 Claude 直接装进了 Word、Excel、PowerPoint,腾讯的 WorkBuddy 走的是同一个路数。
我自己这条公众号流水线就是这么跑的。选题、素材、三版草稿、排版、配图、复盘,全部是一份规则文件加八个 Skills,一行循环代码都没写,每天在产出。
好用是真好用,但它有个副作用。它是怎么一步步转起来的、出了岔子谁来兜底,全被包在里面替你担着了。担得越好,你越意识不到这两样东西存在。而恰恰是这两样,决定了你是只会用,还是会做。
什么时候该走出这一段: 你能用一句具体的话,说出它在哪儿稳定地做不好。说不出来就是真活干得还不够多,继续待着。
二、第二步是自己写一遍循环
这是整条路上性价比最高、也最多人跳过的一步。
那个循环长这样,没有代码:
- 把用户的话,和一份工具清单,一起发给模型
- 模型要么回一段话,要么回“我要调这个工具,参数是这些”
- 你的程序去执行那个工具
- 把执行结果原样塞回对话里
- 连着变长的对话再发一次给模型,回到第 2 步
模型什么时候回的是一段话,循环就在第 2 步结束。
就这些。一个能跑的最小 Agent,主体逻辑二十行上下。
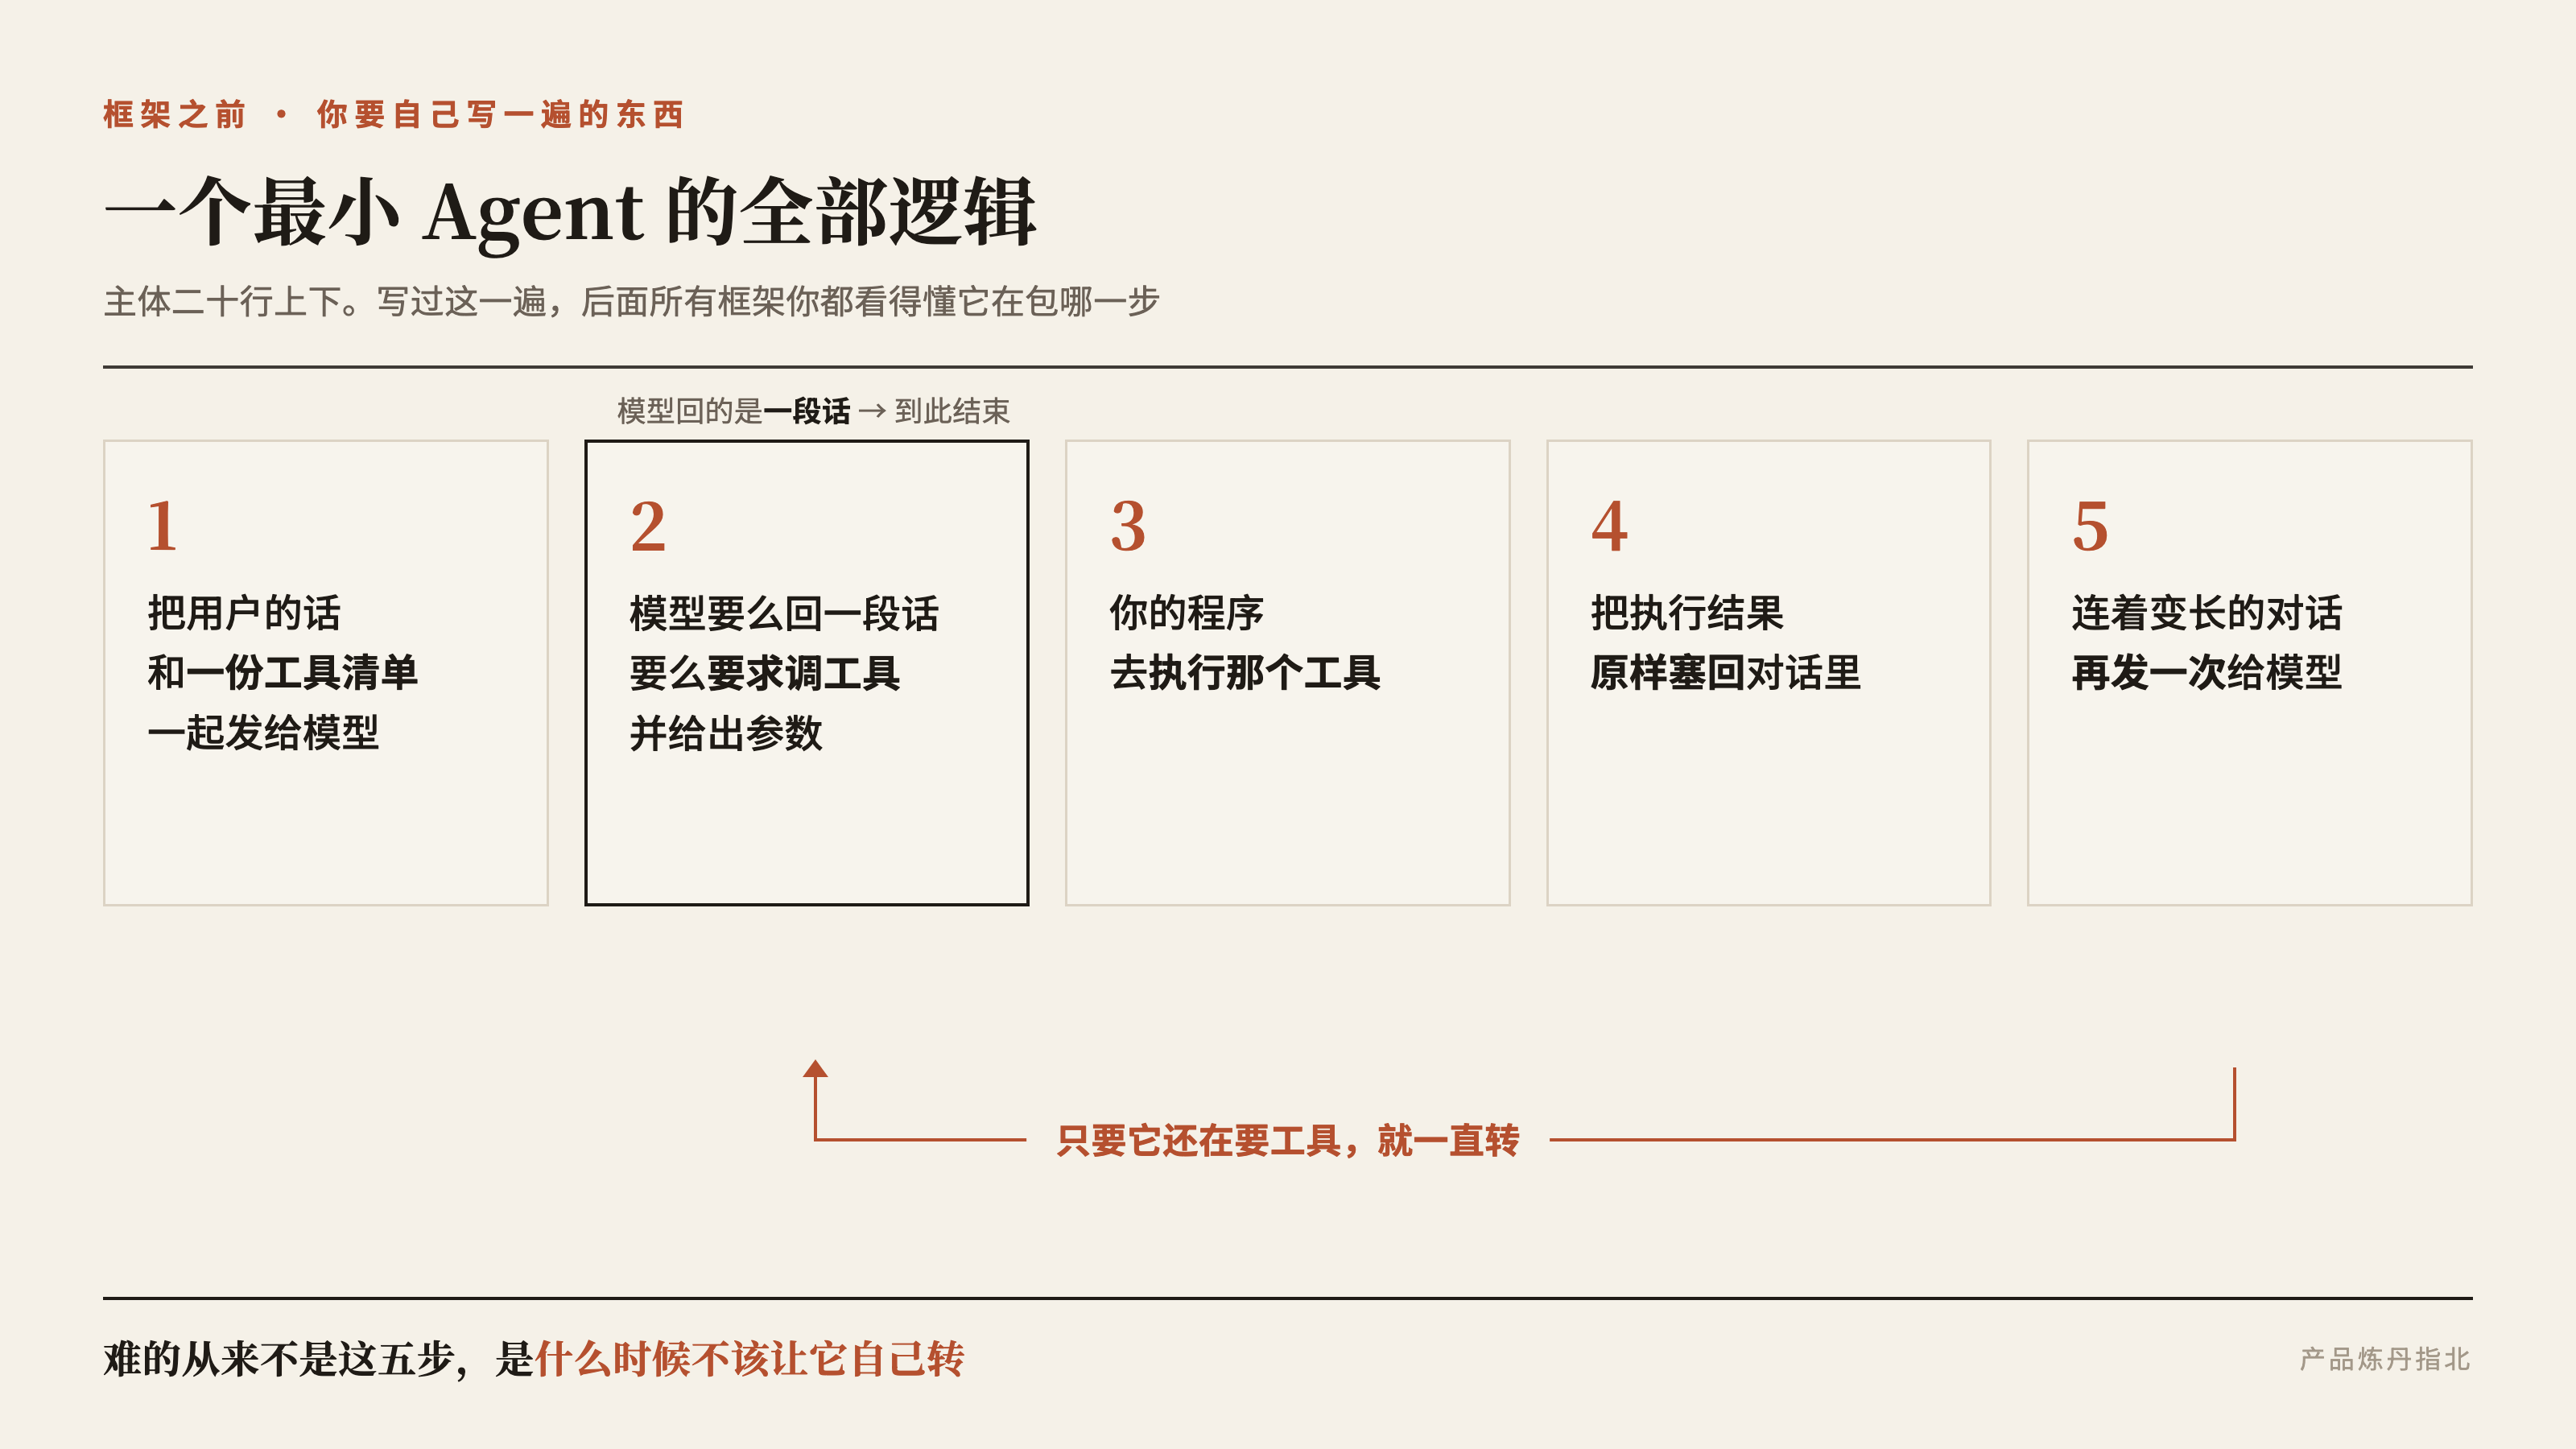 一个最小 Agent 的全部逻辑:五步 + 一个回环
写这二十行的价值不在这二十行,在于它把后面所有东西的坐标系建起来了。
你知道“上下文”具体是哪个变量在变长,才明白为什么长任务会失控,为什么上下文工程这两年成了正经手艺。你知道工具的返回值是被原样塞回去的,才明白返回值该怎么写有多要紧(Anthropic 那篇文章把“认真做 Agent 和计算机之间的接口”单列成一条原则,说的就是这件事)。你知道模型可以连着要求调很多次工具,才明白“要不要设次数上限、要不要加人工确认”是个必须你自己拍板的产品问题,不是框架的默认值。
写完再回头看,LangChain 是把第 1 步和第 5 步的拼装包起来了,LangGraph 是在第 5 步那个回环上加了存档点,OpenClaw 是把第 3 步能调的工具从“你写的几个函数”扩到了“你整台电脑”。你看到的是它们各自包了哪一段,而不是一堆要背的新名词。
还有一件事,写完循环才判断得了:你要做的到底是不是 Agent。
Anthropic 那篇文章把两件事分得很清楚。一种叫 workflow,模型和工具按你预先写好的代码路径走。一种叫 agent,模型自己决定流程、自己决定用什么工具。绝大多数业务需求是前者,前者更好测、更好估成本、出错更好定位。
新人最常见的浪费是:明明是一条固定的三步流水线,非要做成让模型自己决定走哪一步。
跳过前两步直接造,代价长这样
我做过一个投资 Agent,心气最大的那一版直接从最底层开工,自己定义数据契约、自己搭编排、自己写验收。最后建成 306 个 Python 源文件、92 个测试文件、101 份方案文档,系统能跑起来。
然后我发现它没法用。不是崩了,是它给出的建议和后续运行方式,跟我真正需要的决策对不上。
问题不在框架选得对不对。“什么算一条好建议、谁判定它对不对、它能自己动手到哪一步”,这几个业务问题我一个都没先回答,就先去搭架子了。后来那套系统冻结成只读归档,我回到工作台那一层,一份规则文件加几个 Skills 先把业务跑通,至今没有需要自建循环的时刻。
业务还没定型的时候,底层自由度只会把没想清楚的问题变成更多代码。
三、卡住了再选框架
走到这一步,你手里应该有一句具体的话:“我卡在 X 上,自己写解决不了或者不值得自己写。”没有这句话就先别选。
真到了选的时候,新人其实很少去翻榜单,多半是照着“名字听得最多的那个”挑。这就是麻烦所在:声量有滞后,而且它会把压根不是一类的东西排在同一张榜上。写这篇之前我直接调 GitHub、PyPI、npm 的接口把数拉了一遍(2026-08-25),三处对不上:
第一,声量最大的那个根本不是框架。 OpenClaw 38.7 万星,是 LangGraph 的 9.6 倍。但它 npm 月下载 1125 万,LangGraph 是 7103 万,反过来差六倍多。这个比例本身就说明两者不是一个物种:库要被反复安装,每跑一次构建就拉一遍;成品是装一次用很久。开头那句“LangChain 还是 OpenClaw”的病根就在这儿,它们不是两个选项,是两层东西。
第二,星数第一的那个框架,已经交棒了。 AutoGen 6.06 万星,在框架里排最前面,但最近一次正式发版停在 2025 年 9 月,仓库最后一次 push 是今年 4 月 15 号。它不是被扔了:微软今年 2 月宣布把它和 Semantic Kernel 合并成 Microsoft Agent Framework,4 月 3 号发了 1.0。而合并后那个仓库只有 1.31 万星。名字还在传,主线已经搬走了。
第三,最该知道的那层,声量上完全看不见。 MCP 的规范仓库只有 9046 星,但 mcp 这个包 PyPI 月下载 3.6 亿,比所有 Agent 框架加起来还高一个量级。
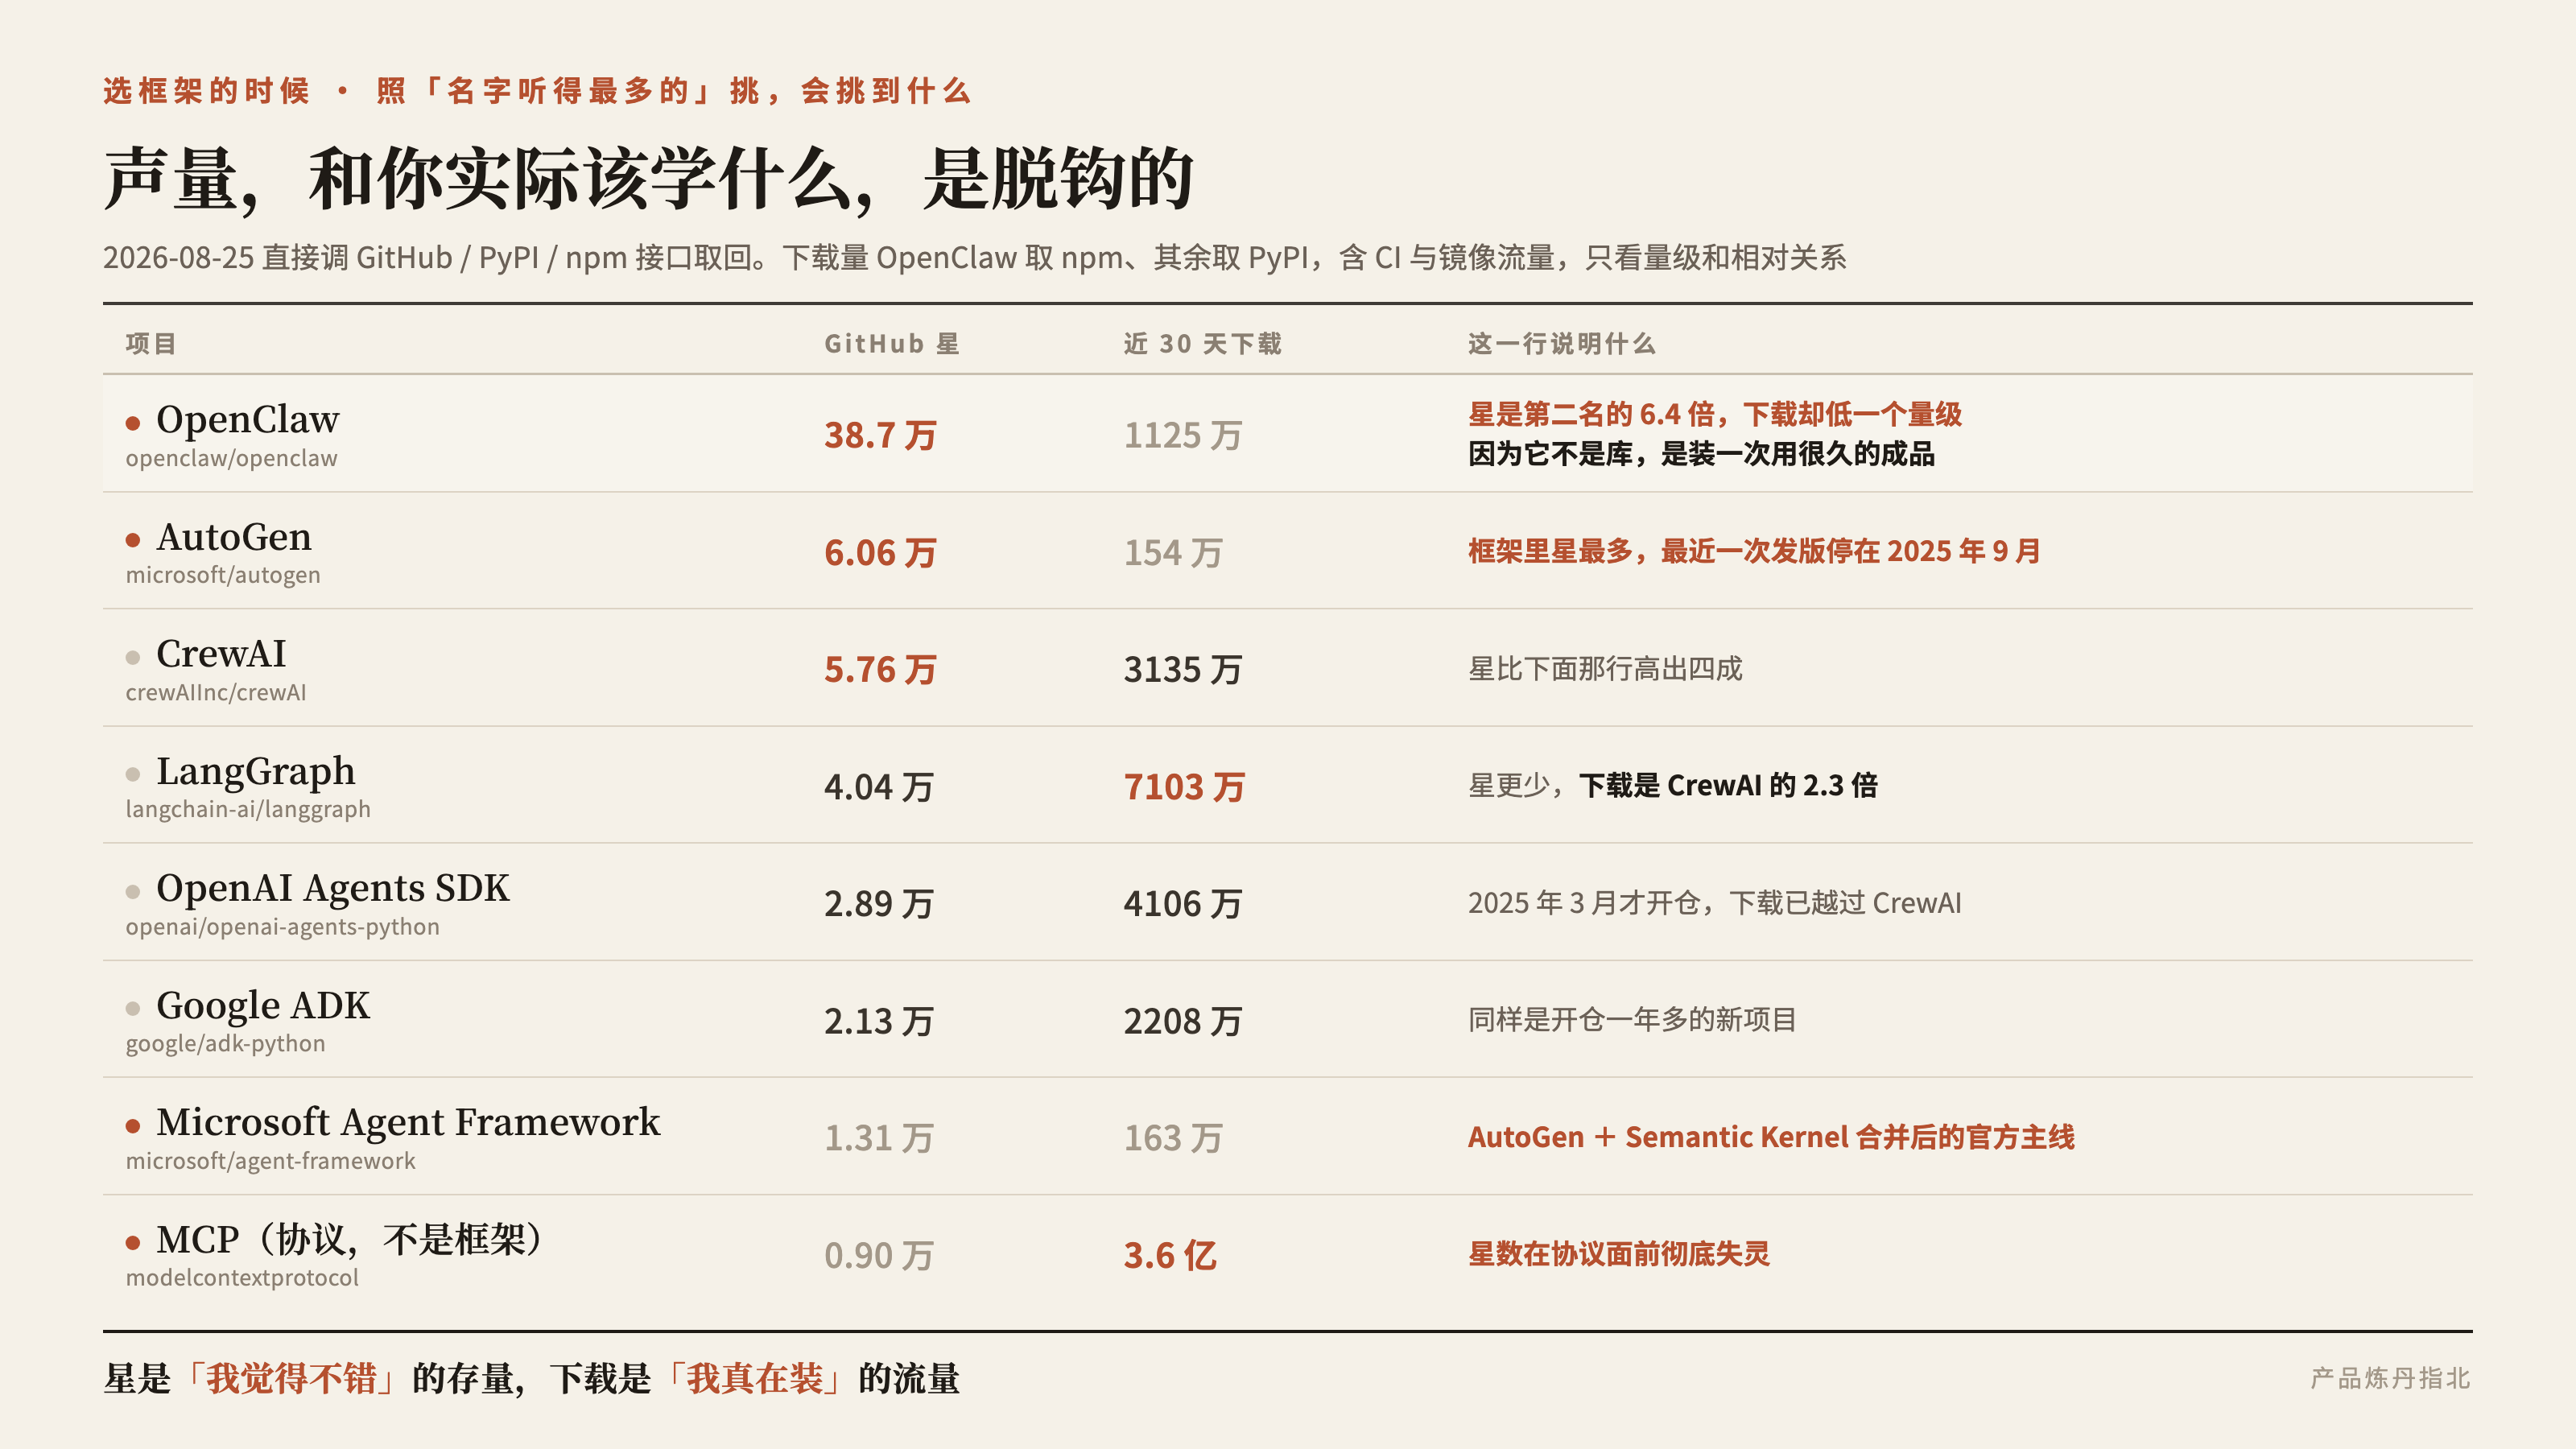 声量和“你实际该学什么”是脱钩的(2026-08-25 实测)
顺着第三条多说一句:接入这件事已经不算差异化了。 MCP 去年 12 月 9 号由 Anthropic 捐给了 Linux Foundation,是新成立的 Agentic AI Foundation 第一个项目,同一批还有 Block 捐的 goose 和 OpenAI 捐的 AGENTS.md;发起方是 OpenAI、Anthropic、Google、微软、AWS、Block 六家。Google 的 A2A 也在同一个基金会下。当年那批互相不兼容的接入方案已经收敛了,“能接多少工具”不再是选框架的理由。
那按什么选?回到第二段那五步,看你卡在哪一步:
- 卡在第 5 步的回环(任务跑一半断了要能接着跑、要能人工插一脚再放回去)→ 看 LangGraph 这一类做有状态编排和存档点的
- 卡在要让好几个循环互相交接 → 看 OpenAI Agents SDK、Microsoft Agent Framework 这一类把交接和护栏做成现成零件的
- 卡在想复用某个工作台已经调好的那套行为(上下文管理、工具链、权限确认)→ 看对应的 Agent SDK,那是把现成工作台的内核当库用
- 卡在第 3 步能调的东西太少(要动本机文件、要跨聊天工具、要操作界面)→ 那你要的不是框架,是 OpenClaw 这类成品,或者给自己的循环接上 MCP
一个提醒:这几类的边界这两年一直在动,各家都在往对方的地盘补功能。所以别按“哪个更强”选,按“哪个在你卡住的那一步上给的东西最直接”选。
最深的那一层:连循环本身都自己造
第二段写那二十行,是为了看懂框架。走到这一层是反过来:框架给的那个循环不够用,你要把它拆了重做。
值得走到这儿的只有一种情况:你这个产品凭什么卖钱,答案就落在循环本身上。比如你要接一批别人接不了的模型,要让好几个 Agent 按你自己设计的方式互相调度,要自己决定任务跑到一半怎么存、怎么捡回来。除此之外都不划算。你换来的那点自由度,是拿“出事更难查”换的。
这个代价我实测过一次。我试过一套“一切皆插件”的开源框架,同一个任务、同一个模型、同一套流程,我只换了运行配置。
浏览器那套跑到需要确认的地方,弹出提问框,等我回答完再接着往下走,最后交出两个文件。命令行那套跑到同一个位置,把问题打印在屏幕上,然后退出了。没有报错,退出码正常,产出目录是空的。
查下来原因很简单:“能不能开口问用户”在那套架构里也是一块可拆的零件,命令行那份配置里没装。
让我记到今天的不是这个毛病本身,是它出事的样子。我另外还拆过一次会话存储,那次它当场就炸了,报错一路点名谁在等谁,半分钟就定位完。拆掉提问这块,它一声不吭,流程照常跑完,只是从“会停下来问你”,悄悄变成了“自己把问题念一遍,然后走人”。
所有零件都正常启动,不等于这件事被办成了。而且越关键的零件缺了,它越安静。
什么时候该走到这一段: 你说得出自己要改循环的哪一步,以及改完之后什么行为会变。说不出来,你要的其实是一个配置项,不是自己造。
四、框架选完,离产品还差三样
这一段最容易被整个跳过去。它正是第一段说的那个副作用:工作台替你担着,所以你从来没见过它长什么样。
生产环境里 Agent 出事,多数不是模型不行。某个工具悄悄调失败了,错的结果被原样塞回对话里,一路带着往下走;框架升了个版本,原来调好的提示词突然不灵了;循环停不下来,一晚上烧掉一笔账单。这些传统的服务监控都看不见,因为程序没崩。
要补的是三样东西。
第一样是闸门,不是嘱咐。
我自己项目的规则文件里有一条“不要在文章里写开发过程”,写得明确、位置靠前,前后被违反过四次。规则文件管住了大多数情况,但它给不了“每次都做到”的承诺。它是给模型的指令,不是强制层。要确定性,得在动作真正执行之前拦一道,比如 Hooks 那类机制,不通过就走不下去。
如果你的业务里有输不起的动作(合规、风控、对外发布),这个区别决定方案能不能上线。
第二样是回执,尤其在你不看着的时候。
自主性该给多少,不看功能,看后果。两个问题就够:这件事错了,多久会被发现?发现的时候还撤得回来吗?
人坐在旁边盯着,发现延迟接近零;交给它自己跑,延迟拉长到“你下次想起来看它”。封号不可逆、对外发布撤不回、付款追不回,这类动作不接受“大概率没事”。
发现延迟乘以可逆程度,等于你能买得起的自主性额度。
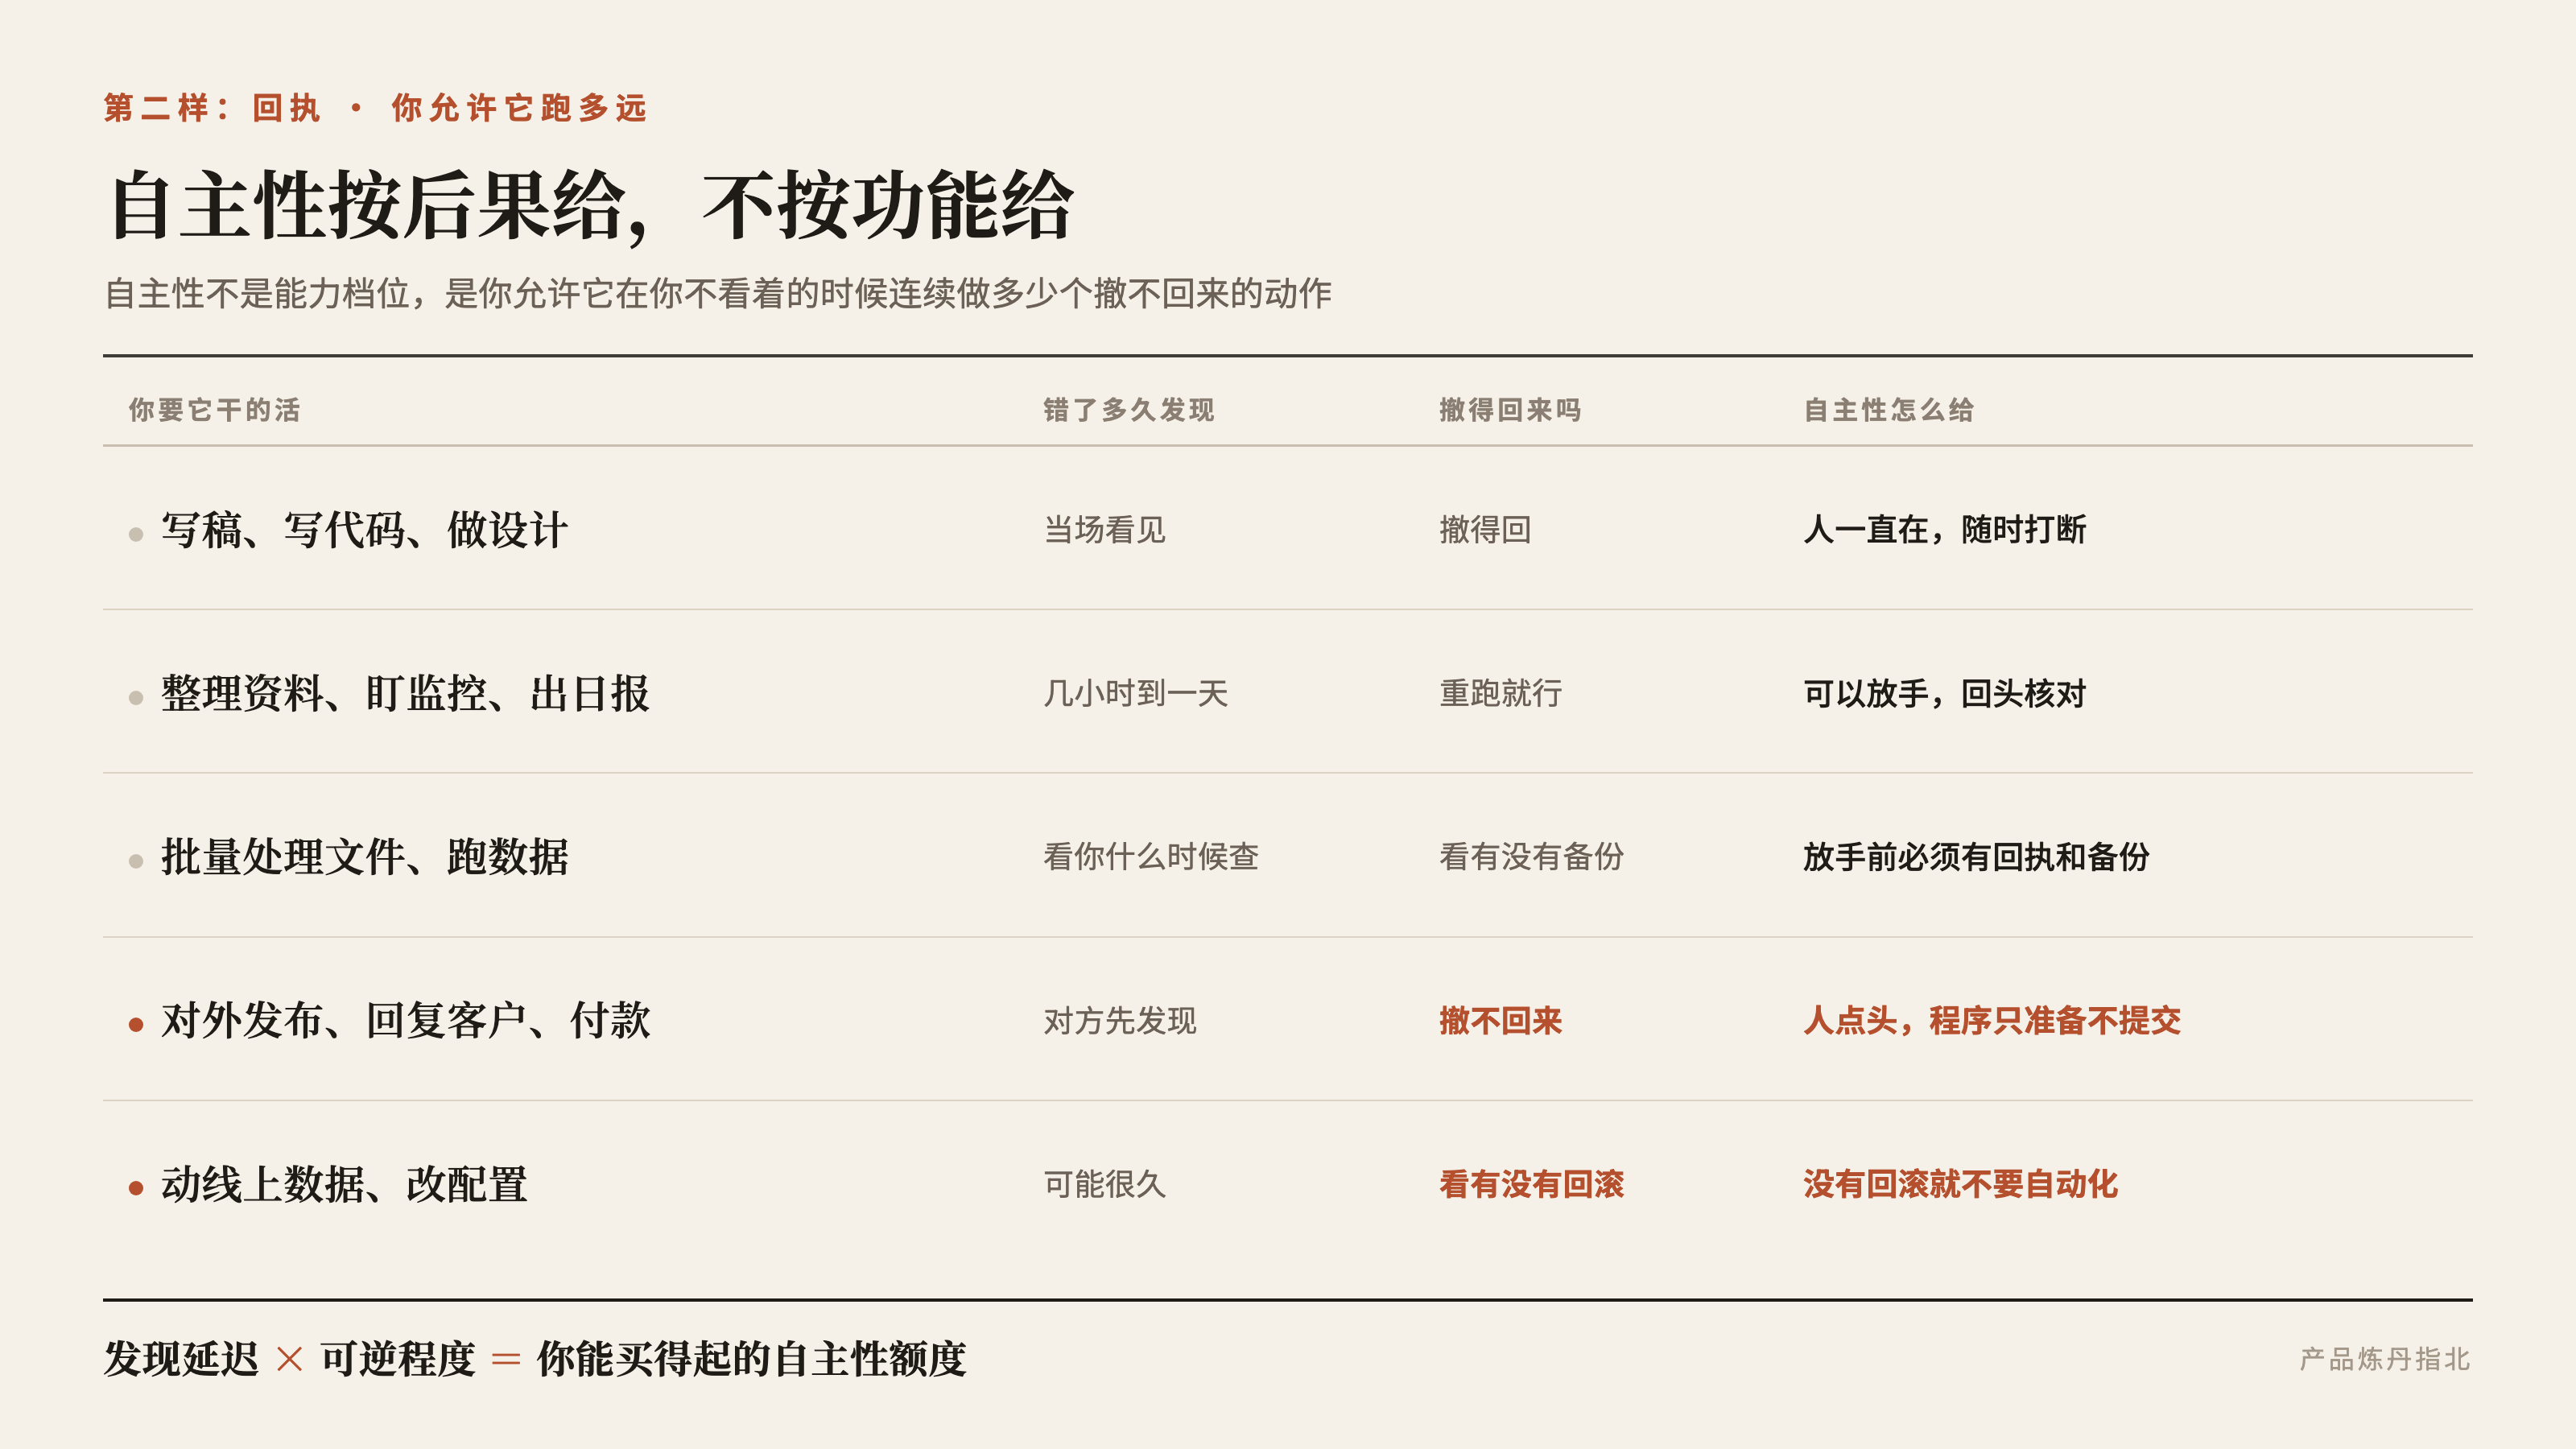 自主性按后果给,不按功能给
顺带说一个产品层面的细节:有些主打自主性的产品把权限确认做成配置项,而工作台那批是把确认做成默认值。默认值才是产品真正的主张,也是九成用户的实际行为。选一个把闸门做成可选项的系统,等于承诺“我们团队每次都记得配”,这个承诺很少有人守得住。
第三样是可回放的轨迹。
Agent 出问题的时候,你要能一步步看它当时调了什么工具、拿回了什么、下一步为什么这么走。没有这个,排查就是靠猜。
这一层现在有专门的工具:LangSmith 跟 LangChain、LangGraph 绑得最紧,闭源,自托管只给企业版;Langfuse 开源可自托管,追踪、评测、成本分析一起给;Braintrust 是评测优先、追踪后补,只有 SaaS 没有自托管。底下用 OpenTelemetry 记,可以让轨迹不锁死在某一家。
具体挑哪个不重要,别把这层整个略过去就行。demo 和产品的差别,很大一部分就在这里。
那我现在在哪一步
三个问题,从上往下答:
- 我能不能用一句具体的话,说出现有方案挡住了哪个业务结果? 说不出来,留在第一段。
- 这个限制是在好几个真实任务里反复出现,还是我对未来的担心? 未来的担心不算。
- 我要改的是业务规则,还是那个循环本身? 大多数时候改规则就够了。
同一个限制在至少三个真实任务里出现过,而且你能写成一句具体的技术描述,才值得往下走一层。
新人真正的风险很少是学得不够深,多半是深度和手上的问题对不上:手里还没有一个跑通的业务,先去选了个框架;或者已经被状态管理折磨了三个月,还在工作台里硬撑。
适合:手里已经有真活在跑、正卡在“要不要学框架、学哪个”这一步的人;以及正在把 Agent 从 demo 往上线推的产品和研发。
不适合:想要一份框架横评打分表的人。本文不做性能、成本、完成率的排名,只讲每一段该在什么时候走出去。
下一步:拿最后那三个问题,对着你手上那个真实项目答一遍,看看自己实际站在第几段。