最近这段时间,我一直在深度折腾 OpenClaw。
为了测试它的能力边界,我给它喂了一整套社交账号,甚至配齐了各种 Skills。但跑了一圈下来,我发现那些真正具有“核心价值”的任务,我始终没敢放手让它去做。
主要卡在两个痛点:
一是安全性,真正的核心账号资产信息,我很难放心全权交托出去;
二是成本冗余,OpenClaw 现有的架构为了兼顾通用性,跑起来有很多冗余动作,任务一复杂,很容易导致 API 账单原地爆炸。
因为这两个痛点,我萌生了一个想法:我要给自己量身定做一套 Private Agent(私人专属助理)。
但在动手造轮子之前,我决定先把它“大卸八块”,好好研究一下这个项目的底层骨架。我花这么多精力去啃它,不是因为它现在有多火,也不是因为它能接飞书、会调几个电脑工具。
而是因为我一直被一个核心问题吸引着:它到底和其他Agent框架有什么区别?
比如同样是我发一句话:
“帮我把这段产品复盘改成一篇小红书,生成 3 个标题,从素材文件夹里选 4 张图,然后直接发出去。”
其他 Agent 框架当然也能做到——让模型调用工具、拆解步骤、逐步执行,这在今天已经不算新鲜事了。
但你真正跑过就会发现,大多数框架解决的是“模型怎么调工具”的问题,却很少有人认真处理另一层:这个任务该派给谁?带上哪些上下文?在哪个会话里执行?工具权限怎么隔离?
而这恰恰是 OpenClaw 最不一样的地方。
我起初也以为 OpenClaw 无非是把这些做得更“全”一点而已——工具多接几个、Prompt 写得更精细、流程封装得更完整。
但当我真正深入源码后才意识到:它多做的那一层,才是整个系统的灵魂所在。
真正兜底让它能丝滑接着干活的,不是什么花哨的 Prompt 技巧,而是它背后那套很多人都没看懂的 Gateway(网关)调度机制。
接下来,我就用上面这个自动发小红书的真实任务当作线索,带你顺着系统的血管走一遍,串起 OpenClaw 的核心工作逻辑,方便大家理解它到底是怎么运转的。
先说结论:飞书不是大脑,模型也不是手脚
如果你看完这篇文章只记一句话,我希望是这句:
飞书(Channel)只是嘴,模型只是脑子,真正把事情串起来的是 Gateway,而真正动手干活的是 browser(浏览器)、exec(命令行)这些工具。
很多人一看 OpenClaw 能“控制电脑”,就脑补出一个赛博数字人,在屏幕前瞪着眼睛看来看去,自己握着鼠标疯狂点击。 实话说,没那么玄乎。
它更真实、也更靠谱的工作流是这样的:
- 任务从飞书(入口)掉进来。
- Gateway 先稳稳接住,判断这是谁的任务、该查什么资料。
- 把整理好的案卷扔给模型。
- 模型说:“好,下一步去开浏览器。”
- 真正去开网页、点按钮的,是底层的 工具(Tools)。
理顺了这个关系,我们再来追踪一下那个小红书任务。
第一站:前台飞书,只负责揽收包裹
任务指令:
“帮我把今天这段产品复盘改成一篇小红书,生成 3 个标题,从素材文件夹里选 4 张图,然后发出去。”
表面上看,这是一气呵成的一句话。但在 OpenClaw 内部,这叫“一个复杂包裹”。
很多人误以为飞书机器人就是系统的主体。其实飞书在这里只是一个前台或者揽收员。它负责把你的原话送进系统,但它不负责理解句子,更不负责决定怎么做。
真正接手拆包裹的,是隐藏在幕后的大管家——Gateway。
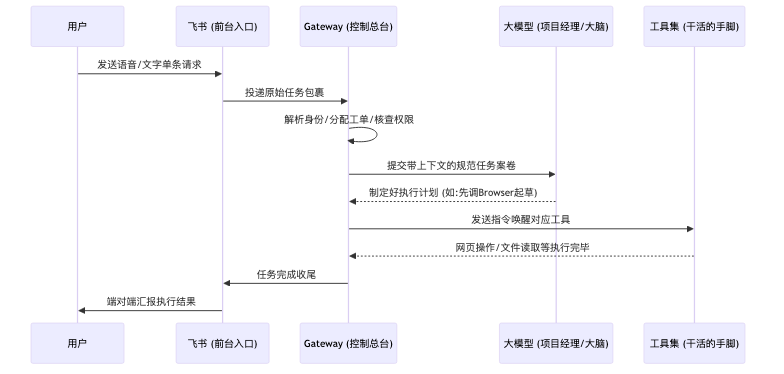 真实任务执行链路
第二站:总控台 Gateway,决定了 AI 到底有多聪明
我之前一直觉得 Agent(智能体)、Tool(工具)最牛,后来才发现,OpenClaw 最核心的灵魂,恰恰是名字最容易让人误会的 Gateway。
它听起来像个无情的路由器网络节点,但实际上,它是整个系统的**“总控台”**。它是前台调度员、会话管理员、上下文装配器和权限保安的四合一。
当包裹(消息)来到 Gateway,它不会直接把原始消息丢给模型,而是先发出“灵魂四问”:
- 这是谁发来的?(渠道、账号)
- 该交给哪个工种干?(如果是私聊,交给个人助理;如果是运营群,则路由到内容运营 Agent。)
- 要带上哪些历史资料?(沿用哪个 Session,不仅如此,还要看这个 Agent 的岗位说明书、过往工作习惯。)
- 这次允许动用什么工具?(能不能联外网?能不能访问本地硬盘?)
你看,模型不是在一个无限开放的世界里自由发挥,而是在 Gateway 提前划定好的安全、精准的工作区里做题。
如果你不明白 Gateway 有多重要,请想象一下:公司进了一个新需求,如果没有这层过滤,直接扔给全公司所有人,那必定是一团乱麻。Gateway 就是那个先把案卷整理得明明白白,再递给专家的老道秘书。
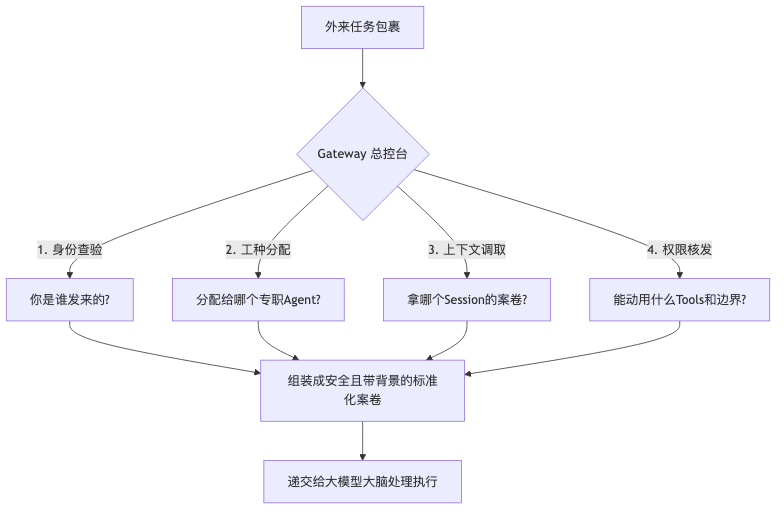 Gateway 到底在控制什么
第三站:大脑出场,模型只是项目经理
任务被 Gateway 分好类、装配好“说明书”和“工单历史”后,终于来到了模型面前。
这时候模型看到的,不是孤零零的一句话,而是:
- 任务目标:发小红书。
- 当前进度:刚刚收到。
- 角色设定:你是一个资深爆款内容运营。
- 兜里有的工具:浏览器控制权、本地文件读取权。
接下来,模型开始做规划(Plan):
- 先改写文案。
- 调起文件读取工具,拿 4 张图。
- 调起浏览器工具,打开小红书网页。
- 填字,传图。
- 点“发布”。
- 告诉老板(通过飞书回复)动作搞定了。
注意!模型只负责输出这份执行计划,它本身并不执行任何操作。 它此时的角色更像项目经理——负责规划和下发指令,指哪打哪。
第四站:底层工具执行,谁才是真正的“手和脚”?
那么到底是谁在点鼠标、敲键盘?
是一组不具备自主决策能力、但执行精度极高的工具集。
- 对于发小红书,Gateway 会唤醒 Browser(浏览器自动化工具)。模型说“去点那个红色的发布按钮”,Browser 工具就精确定位去点。
- 如果是压缩图片、读取本地素材,就会唤醒 Exec 和文件工具。
- 更妙的是 Node(节点能力)。如果系统跑在云端,但素材都在你的办公 Mac 上怎么办?OpenClaw 能把你的办公电脑变成一个 Node,指令在云端下发,动作在你眼皮子底下的真机上执行。
所以,所谓**“AI 控制你的电脑”**,其实是:Gateway 居中调度,Node 挂载在你的终端上勤勤恳恳地当打工人。
隐形彩蛋系统:那些藏在背后的“记忆”与“心跳”
看到这里,这个发小红书的任务其实已经走完了。 但是,如果你要用它打长工,很快就会面临一个问题:聊得越多,它脑子越糊涂,历史记录像面条一样扯不断理还乱。
这就引出了 OpenClaw 最让我拍案叫绝的两个设计:记忆(Memory)与心跳(Heartbeat)。
普通的 AI 聊天记录,一关就没了。 但在 OpenClaw 里,记忆是外部持久化的:
- Daily Memory(日记):今天发生了什么,任务卡在哪里了,临时规矩是什么。
- 长期记忆:老板喜欢用哪种 Emoji,项目的长期风格是什么。
这就像它有个专属记事本,永远不会忘。
光有记事本还不够,还得有人翻。这就是 Heartbeat(心跳机制/定时巡逻)。它不是普通的系统保活 Ping,它是巡逻探照灯。
你可以规定它每半小时醒一次:
- 去看看今天排期的小红书发了没?
- 去瞄一眼投资情报库有没有更新?
一旦有事,它立马顺着链路通知你;没事,它就静悄悄地继续睡。
记忆管的是“经验怎么沉淀”,心跳管的是“AI 什么时候主动找你”。 这一对组合拳打下来,它才真正活成了一个带有主观能动性的“私人助理”。
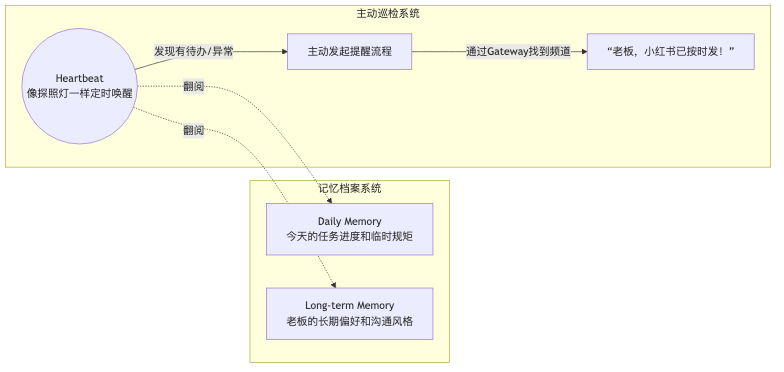 记忆和心跳的关系
总结:真正的系统能力,从来不只靠模型
它实际上把 AI 助理拆成了七层:
| 层级 | 职责 | 对应组件 |
|---|---|---|
| 入口层 | 消息从哪来 | 飞书、Telegram、WhatsApp |
| 控制层 | 谁来分流、装配上下文 | Gateway |
| 角色层 | 谁来处理 | 不同 Agent |
| 会话层 | 在哪个上下文里处理 | 不同 Session |
| 记忆层 | 怎么沉淀和复用信息 | Daily Memory + Long-term Memory |
| 执行层 | 谁真正动手 | browser、exec、nodes |
| 巡检层 | 什么时候主动检查 | Heartbeat |
一个真正能长期工作的 AI 助理,靠的从来不只是模型。更靠的是:你怎么组织入口、怎么做分流、怎么隔离上下文、怎么沉淀记忆、怎么定义工具边界、怎么让它按时主动巡检。
了解完这一切后,我已经让GPT结合我的具体痛点,给我出了几个自研框架的设计方案。接下来,我也打算按这个逻辑,尝试把自己的碎片化工作管起来,积累专属的私域上下文,让我的 Private Agent 开始持续迭代进化。
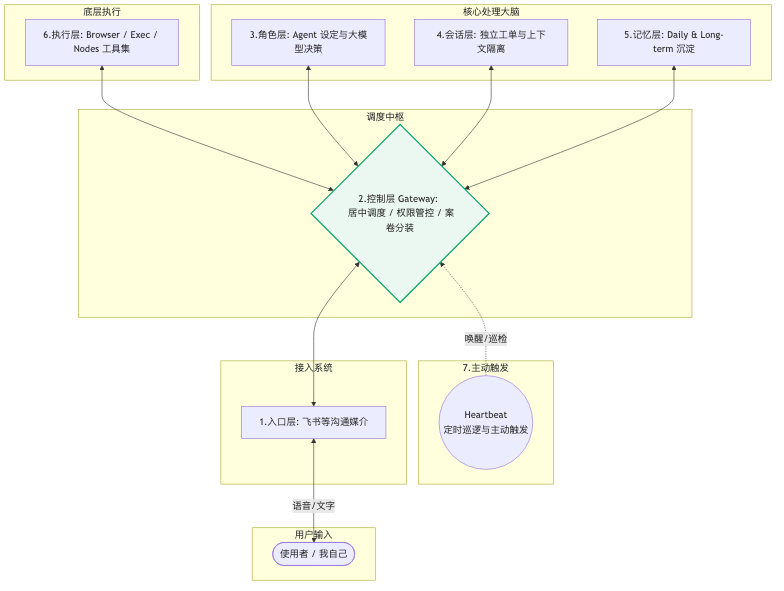 我的 Agent 结构说明
这,才是一个私人 Agent 操作系统该有的样子。